Khi AI nói tiếng Việt: Cuộc đua không chỉ của người Việt
Tháng 3/2026, tôi thử hỏi ChatGPT một câu đơn giản: “Cho tôi 5 câu ca dao về con trâu”. Kết quả: 2 trong 5 câu hoàn toàn bịa đặt. Cùng câu hỏi đó với Claude: đúng cả 5 nhưng giải thích sai ngữ cảnh văn hóa của 2 câu.
Đây không phải lỗi của AI. Đây là giới hạn của AI khi làm việc với tiếng Việt: một ngôn ngữ có hơn 100 triệu người nói nhưng dữ liệu huấn luyện chỉ chiếm chưa đến 0,3% tổng dữ liệu Internet.
Bài viết này là bức tranh toàn cảnh về AI tiếng Việt năm 2026: ai đang làm gì, đâu là sản phẩm thực sự, và tại sao đây không chỉ là câu chuyện công nghệ.
AI tiếng Việt không chỉ là ChatGPT dịch sang tiếng Việt. Đó là cả một hệ sinh thái: mô hình ngôn ngữ, trợ lý ảo, dữ liệu huấn luyện, và ứng dụng thực tế do người Việt làm cho người Việt.
Vấn đề: Tại sao AI quốc tế “đuối” với tiếng Việt?
Tiếng Việt có 3 đặc điểm khiến nó trở thành thách thức với các mô hình AI quốc tế:
1. Dấu thanh và ngữ nghĩa. “Ma”, “má”, “mà”, “mả”, “mã”, “mạ” là 6 từ hoàn toàn khác nhau. Mất dấu là mất nghĩa. Trong khi đó, hầu hết dữ liệu huấn luyện của AI quốc tế là tiếng Anh (46% theo Common Crawl), tiếng Việt chỉ chiếm 0,3%.
2. Từ đồng âm và ngữ cảnh văn hóa. “Chạy” có thể là chạy bộ, chạy deadline, chạy quảng cáo, chạy án… AI cần ngữ cảnh văn hóa để hiểu, và ngữ cảnh đó chỉ có trong dữ liệu tiếng Việt chất lượng cao.
3. Dữ liệu tiếng Việt trên Internet phần lớn là content thương mại. Theo khảo sát của dự án ViGen (Bộ KH&CN, 2025), hơn 60% dữ liệu tiếng Việt chất lượng cao nằm trong sách, báo, văn bản pháp luật chưa được số hóa hoặc số hóa chưa chuẩn. Trong khi đó, nội dung tiếng Việt công khai trên web lại thiên về thương mại và giải trí.
Theo thống kê từ Common Crawl (dataset huấn luyện chính của hầu hết LLM), tiếng Việt xếp thứ 15 về dung lượng dữ liệu, sau tiếng Thái, tiếng Ả Rập, và tiếng Hà Lan. Một ngôn ngữ 100 triệu người nói có ít dữ liệu hơn tiếng Hà Lan (24 triệu người nói).
Cuộc đua AI tiếng Việt: 4 nhóm chính
Không chỉ có một “AI tiếng Việt”. Có 4 nhóm đang cùng phát triển với cách tiếp cận khác nhau:
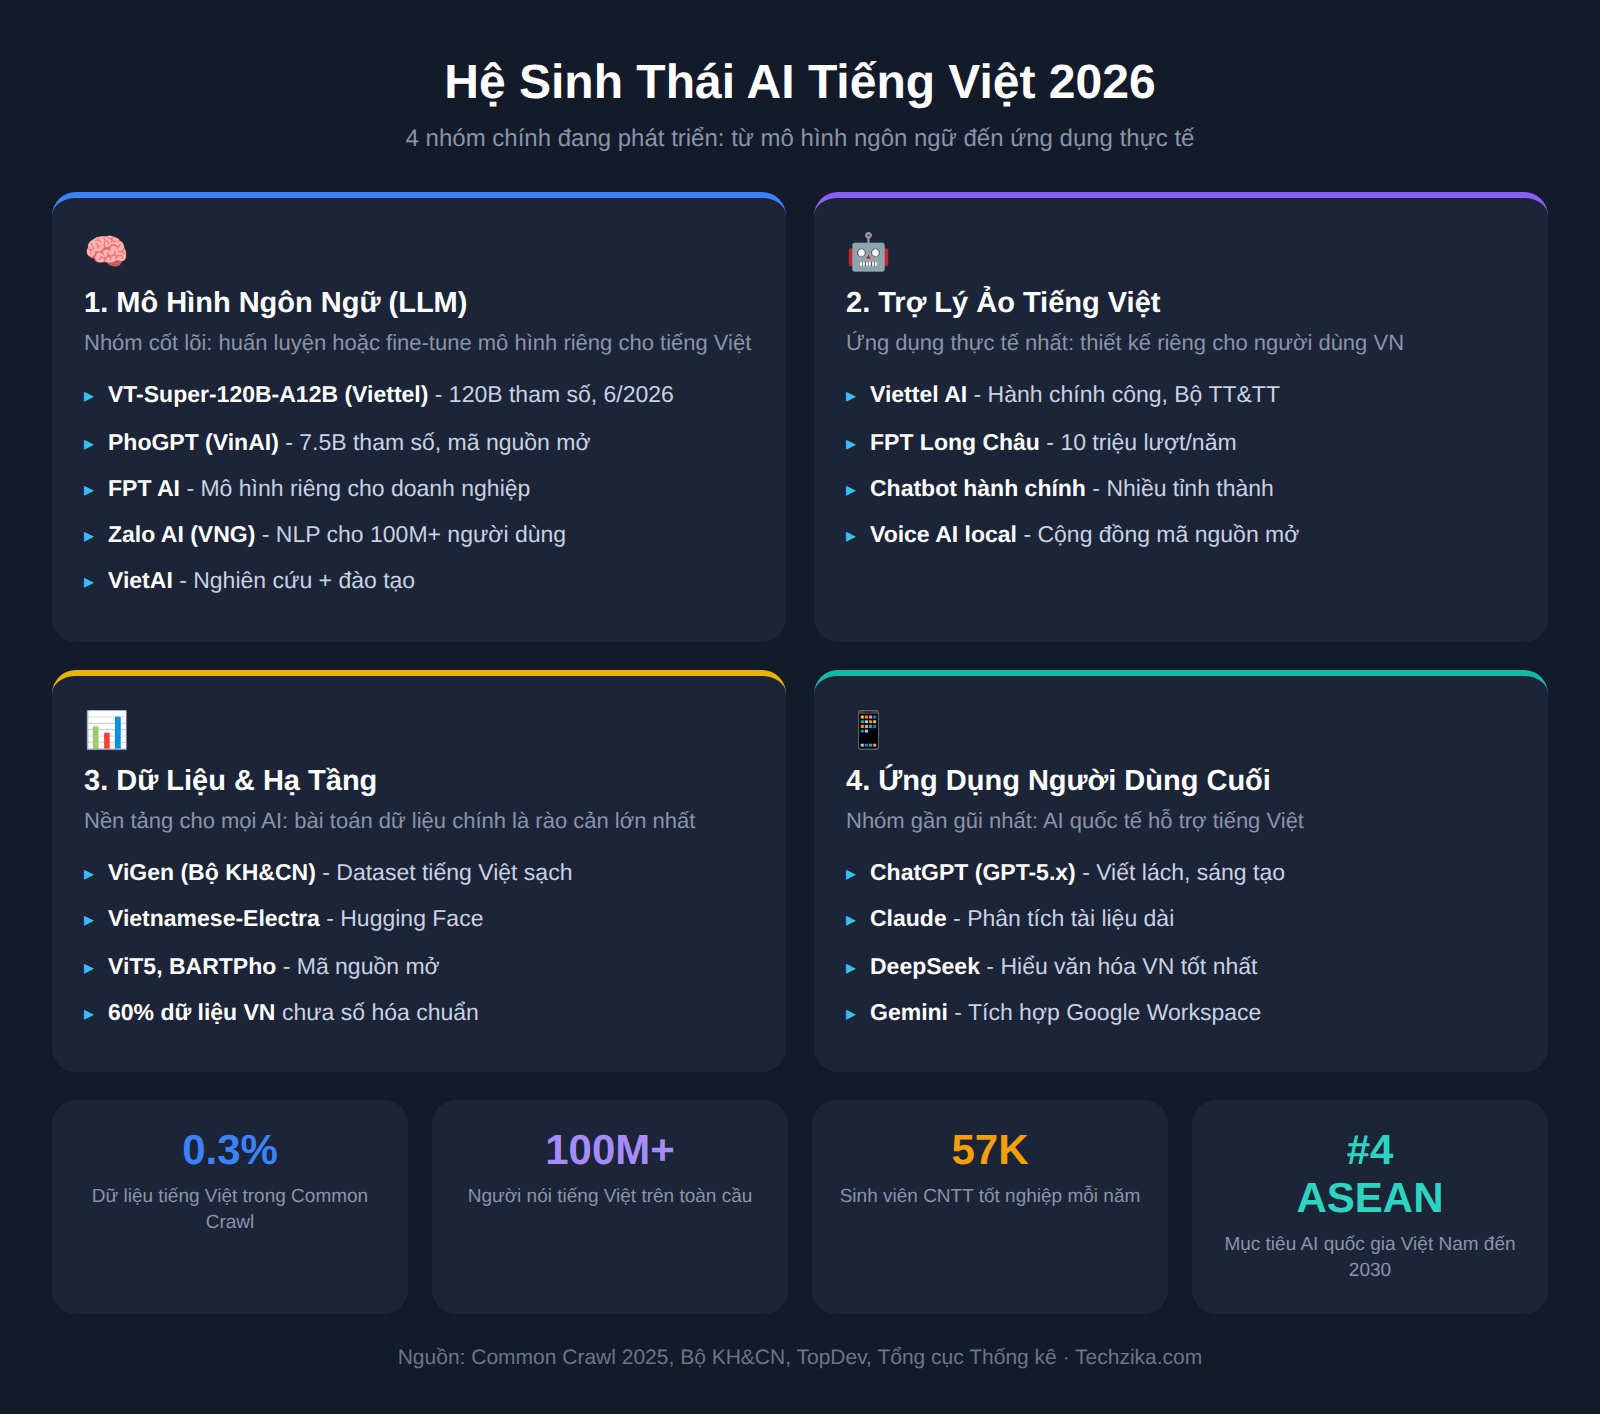
1. Mô hình ngôn ngữ lớn tiếng Việt (Vietnamese LLM)
Đây là nhóm cốt lõi. Họ huấn luyện hoặc fine-tune LLM riêng cho tiếng Việt:
- PhoGPT (VinAI/Vingroup): Mô hình 7,5B tham số, huấn luyện từ đầu trên dữ liệu tiếng Việt. Điểm mạnh: sinh văn bản tiếng Việt tự nhiên, hiểu ngữ cảnh văn hóa. Mã nguồn mở.
- VT-Super-120B-A12B (Viettel AI): Mô hình 120 tỷ tham số do kỹ sư Viettel huấn luyện dựa trên kiến trúc NVIDIA Nemotron 3 Super, công bố tháng 6/2026. Điểm mạnh: huấn luyện trên dữ liệu bản địa (hành chính, nghiệp vụ doanh nghiệp, hội thoại thực tế) và đạt hiệu suất thuộc nhóm dẫn đầu so với các mô hình cùng quy mô (VnExpress, 6/2026).
- FPT AI (FPT): Họ không công bố mô hình riêng mà xây dựng nền tảng AI ứng dụng trên cả model quốc tế (fine-tune) và model tự phát triển. Trọng tâm là trợ lý ảo cho doanh nghiệp. Tháng 6/2026, FPT trở thành NVIDIA Cloud Partner, cung cấp hạ tầng compute phục vụ các sáng kiến AI có chủ quyền tại châu Á (TNGlobal, 6/2026).
- Zalo AI (VNG): Phát triển AI cho hệ sinh thái Zalo (100M+ người dùng VN), tập trung vào NLP tiếng Việt cho chatbot và trợ lý.
- VietAI: Tổ chức phi lợi nhuận đầu tiên ở Việt Nam đào tạo AI chuyên sâu, có nghiên cứu về NLP tiếng Việt.
Theo tôi, sự xuất hiện của VT-Super-120B-A12B là tín hiệu đáng chú ý nhất của AI tiếng Việt năm 2026: lần đầu tiên một mô hình do doanh nghiệp Việt huấn luyện đạt nhóm dẫn đầu cùng quy mô trên chính nền tảng mô hình mở của NVIDIA, thay vì chỉ fine-tune từ model có sẵn. Điều đó cho thấy bài toán “làm chủ LLM tiếng Việt” đã chuyển từ nghiên cứu sang cạnh tranh thực chất.
2. Trợ lý ảo tiếng Việt
Ứng dụng thực tế nhất của AI tiếng Việt. Không phải ChatGPT dịch ra tiếng Việt, mà là trợ lý được thiết kế riêng cho người dùng VN:
- Viettel AI: Trợ lý ảo cho khối hành chính công, đang thử nghiệm với Bộ TT&TT. Hỗ trợ xử lý văn bản hành chính tiếng Việt. Tháng 6/2026, NVIDIA xác nhận Viettel AI đang xây dựng ứng dụng AI pháp lý quy mô quốc gia trên hạ tầng mô hình mở của NVIDIA (TNGlobal, 6/2026).
- FPT Long Châu: Trợ lý ảo chăm sóc sức khỏe, mục tiêu phục vụ 10 triệu lượt người dùng từ 2026.
- Chatbot hành chính công: Nhiều tỉnh thành đã triển khai chatbot AI trả lời thủ tục hành chính bằng tiếng Việt.
3. Dữ liệu và hạ tầng
- ViGen (Bộ KH&CN): Dự án xây dựng bộ dữ liệu tiếng Việt chất lượng cao cho huấn luyện AI, gồm văn bản hành chính, pháp luật, y tế, giáo dục.
- Cộng đồng mã nguồn mở: Các dự án như Vietnamese-Electra, ViT5, BARTpho trên Hugging Face.
4. Ứng dụng AI tiếng Việt cho người dùng cuối
Đây là nhóm gần gũi nhất với người dùng phổ thông:
- ChatGPT + Claude + Gemini: Cả 3 đều hỗ trợ tiếng Việt ở mức khá tốt (2026), nhưng vẫn mắc lỗi văn hóa và ngữ cảnh.
- Voice AI tiếng Việt: Công nghệ kết hợp Whisper (nhận diện giọng nói) + LLM (xử lý) + XTTS (đọc tiếng Việt) đang cho phép xây dựng trợ lý giọng nói tiếng Việt chạy local. Cộng đồng AI Việt Nam đã có hướng dẫn chi tiết.
- DeepSeek: Hỗ trợ tiếng Việt khá tốt, đặc biệt reasoning bằng tiếng Việt tự nhiên hơn nhiều model phương Tây.
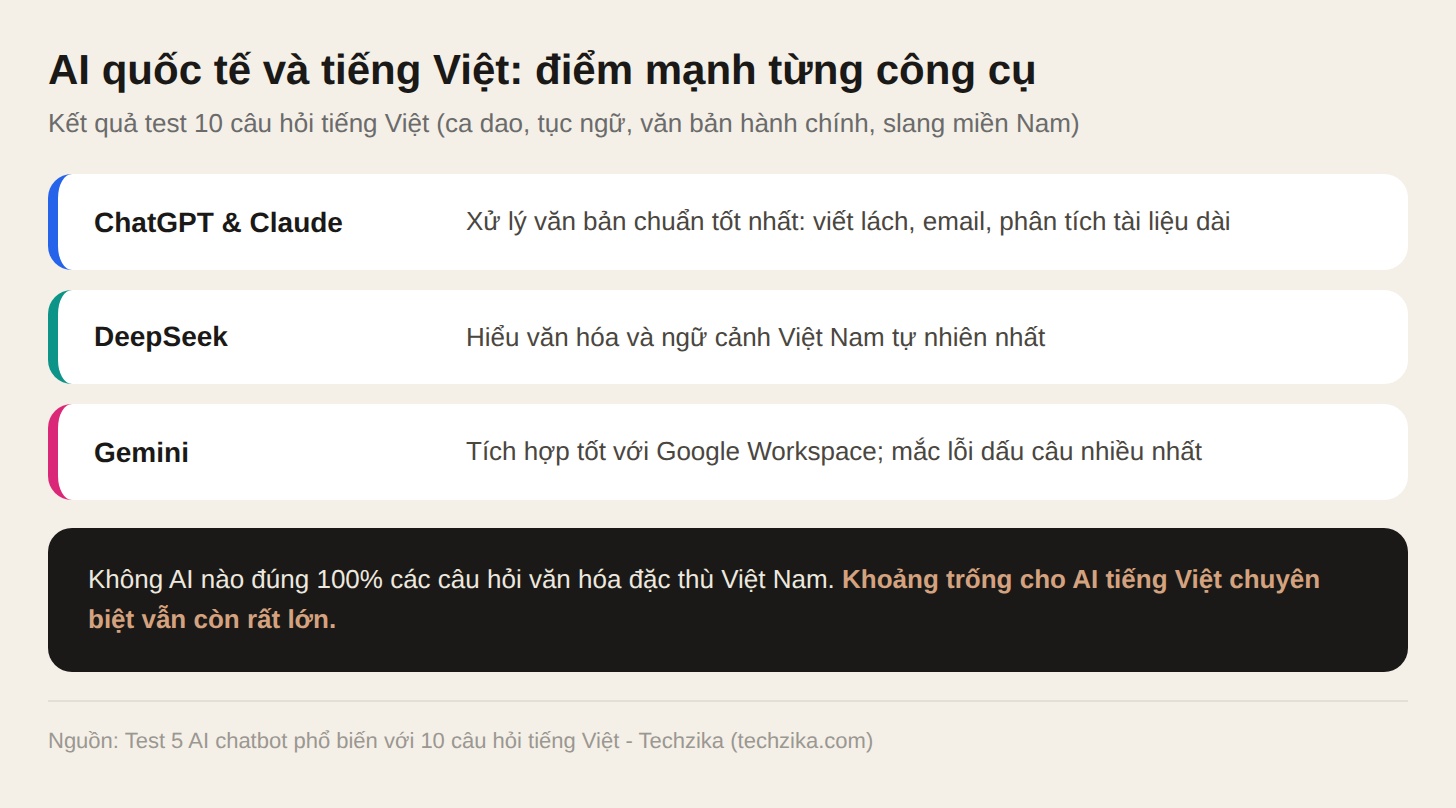
Tôi đã test 5 AI chatbot phổ biến với cùng 10 câu hỏi tiếng Việt (gồm ca dao, tục ngữ, văn bản hành chính, slang miền Nam). Kết quả: ChatGPT và Claude xử lý tốt nhất văn bản chuẩn. DeepSeek cho kết quả tự nhiên nhất trong hiểu văn hóa và ngữ cảnh VN. Gemini mắc lỗi dấu câu nhiều nhất. Nhưng không AI nào đúng 100% các câu hỏi văn hóa đặc thù. Khoảng trống cho AI tiếng Việt chuyên biệt vẫn còn rất lớn.
Thách thức lớn nhất: Dữ liệu
Bài toán AI tiếng Việt thực chất là bài toán dữ liệu. Mô hình có giỏi đến đâu mà dữ liệu huấn luyện tiếng Việt kém chất lượng thì output cũng kém.
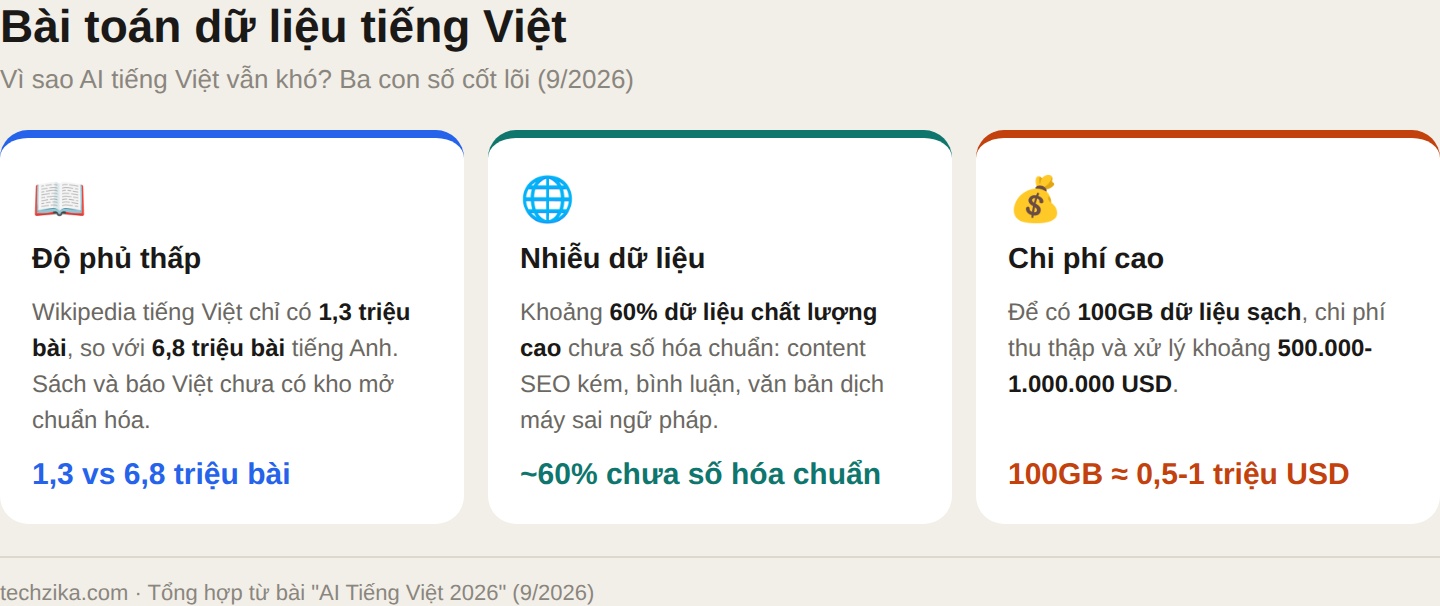
3 vấn đề chính:
1. Thiếu dữ liệu chất lượng cao. Wikipedia tiếng Việt có 1,3 triệu bài, so với 6,8 triệu bài tiếng Anh. Sách tiếng Việt số hóa còn ít. Báo chí Việt Nam chưa có kho dữ liệu mở chuẩn hóa.
2. Nhiễu dữ liệu. Content tiếng Việt trên web nhiều nhưng phần lớn là: content SEO kém chất lượng, bình luận mạng xã hội thiếu chuẩn mực, văn bản dịch máy từ tiếng Anh sai ngữ pháp.
3. Chi phí thu thập và xử lý. Để có bộ dữ liệu 100GB tiếng Việt sạch, chi phí ước tính 500.000-1.000.000 USD cho riêng khâu thu thập và làm sạch. Với startup Việt, đây là rào cản lớn.
Cơ hội: AI tiếng Việt là “blue ocean”
Chính vì khó nên AI tiếng Việt là cơ hội. Khi thị trường AI tiếng Anh đã bão hòa với hàng trăm công ty, AI tiếng Việt vẫn còn là mảnh đất trống:
- 100+ triệu người dùng tiềm năng: Không chỉ Việt Nam, còn cộng đồng người Việt ở nước ngoài (~5 triệu)
- Chính phủ ủng hộ: Chiến lược quốc gia về AI đến 2030 đặt mục tiêu Việt Nam vào top 4 ASEAN về AI
- Doanh nghiệp sẵn sàng chi trả: Trợ lý ảo cho ngân hàng, bảo hiểm, hành chính công sẵn sàng trả 50.000-200.000 USD/năm cho giải pháp
- Nguồn nhân lực dồi dào: Việt Nam có hơn 57.000 sinh viên CNTT tốt nghiệp mỗi năm
Đầu tư vào AI tiếng Việt không dành cho người muốn lợi nhuận nhanh. FPT mất 5+ năm R&D mới ra được sản phẩm thương mại. Đây là cuộc chơi dài hạn, cần kiên nhẫn và vốn lớn.
AI tiếng Việt sẽ đi về đâu trong 2-3 năm tới?
Dựa trên các tín hiệu hiện tại, tôi dự đoán 3 xu hướng chính:
1. Trợ lý ảo hành chính công sẽ là “killer app”. Với sự hậu thuẫn của Chính phủ và nhu cầu thực tế (giảm tải cho cán bộ, minh bạch thủ tục), đây sẽ là mảng bùng nổ đầu tiên của AI tiếng Việt. Viettel và FPT đang dẫn đầu.
2. Voice AI tiếng Việt sẽ phổ biến nhờ mô hình mã nguồn mở. Sự kết hợp Whisper + XTTS + LLM mã nguồn mở (như PhoGPT, Qwen) cho phép bất kỳ ai cũng có thể build trợ lý giọng nói tiếng Việt với chi phí thấp.
3. AI quốc tế sẽ cải thiện tiếng Việt nhanh hơn AI nội địa. Nghịch lý: OpenAI, Google, Anthropic có nhiều tiền và GPU hơn để fine-tune tiếng Việt so với startup Việt. Họ có thể “bắt kịp” về chất lượng tiếng Việt trước khi AI Việt Nam kịp ra thị trường. Đây là rủi ro thực sự cho các dự án AI nội địa.
Lời kết: AI tiếng Việt là câu chuyện của 100 triệu người
AI tiếng Việt không phải vấn đề “có hay không”, mà là “khi nào và ai làm”. Một ngôn ngữ 100 triệu người nói xứng đáng có AI hiểu nó đúng mực. Không phải AI dịch từ tiếng Anh sang, mà là AI được sinh ra từ tiếng Việt, nuôi dưỡng bằng văn hóa Việt.
Tôi bắt đầu quan tâm đến AI tiếng Việt từ một trải nghiệm nhỏ: dùng AI dịch một bài thơ của Nguyễn Duy sang tiếng Anh, rồi dịch ngược lại. Kết quả là một bài thơ hoàn toàn khác. Lúc đó tôi hiểu rằng AI giỏi đến mấy mà không thấm văn hóa Việt thì vẫn chỉ là công cụ dịch thuật, không phải là trí tuệ.
Khoảng trống vẫn còn. Cơ hội vẫn còn. Và thời điểm để bắt đầu là bây giờ.
Câu hỏi thường gặp
ChatGPT có hỗ trợ tiếng Việt tốt không?
Tính đến tháng 9/2026, ChatGPT (GPT-5.x) và Claude (Opus 4.x/5) hỗ trợ tiếng Việt ở mức khá tốt cho giao tiếp thông thường, viết email, dịch thuật cơ bản. Tuy nhiên, cả hai vẫn mắc lỗi với văn bản hành chính, văn học, ca dao tục ngữ, và các ngữ cảnh văn hóa đặc thù Việt Nam. Nếu bạn cần dùng AI tiếng Việt cho công việc chuyên môn (luật, y tế, hành chính), nên kiểm tra kỹ output hoặc chờ các giải pháp AI tiếng Việt chuyên biệt.
Việt Nam có mô hình AI ngôn ngữ riêng chưa?
Đã có. Đáng chú ý nhất là VT-Super-120B-A12B của Viettel AI (120 tỷ tham số, công bố tháng 6/2026) đạt hiệu suất thuộc nhóm dẫn đầu cùng quy mô. Ngoài ra, PhoGPT của VinAI (7,5B tham số) là mô hình mã nguồn mở huấn luyện từ đầu cho tiếng Việt, cùng các mô hình fine-tune từ mã nguồn mở như Vietcuna, Vietnamese-Llama. FPT cũng có mô hình riêng nhưng chưa công bố rộng rãi. Tuy nhiên, các mô hình này vẫn có quy mô nhỏ hơn nhiều so với ChatGPT hay Claude (hàng trăm tỷ tham số).
Dùng AI nào cho tiếng Việt tốt nhất hiện tại?
Tùy mục đích: ChatGPT tốt nhất cho viết lách và sáng tạo nội dung tiếng Việt. Claude tốt nhất cho phân tích tài liệu tiếng Việt dài và code. DeepSeek hiểu văn hóa Việt Nam tốt nhất. Gemini tích hợp tốt với Google Workspace. Perplexity tốt cho research có trích dẫn nguồn. Không có AI nào “best” cho mọi tác vụ tiếng Việt.
Dự án ViGen là gì?
ViGen (Vietnamese Data Generation) là dự án của Bộ Khoa học và Công nghệ, khởi động năm 2025, nhằm xây dựng bộ dữ liệu tiếng Việt chất lượng cao cho huấn luyện AI. Mục tiêu: tạo ra dataset tiếng Việt đủ lớn và sạch để các mô hình AI có thể hiểu và sinh tiếng Việt tự nhiên, bao gồm văn bản hành chính, pháp luật, y tế, giáo dục. Đây là dự án nền tảng cho toàn bộ hệ sinh thái AI tiếng Việt.
Có nên đầu tư vào cổ phiếu công ty AI Việt Nam không?
Bài viết này không đưa ra lời khuyên đầu tư. Tuy nhiên, góc nhìn thực tế: AI là cuộc chơi dài hạn và tốn kém. FPT (mã FPT) là công ty niêm yết duy nhất có mảng AI rõ ràng tại Việt Nam. VNG chưa niêm yết. Các công ty khác hoặc chưa đủ lớn hoặc chưa minh bạch về mảng AI. Nếu quan tâm đầu tư, hãy nghiên cứu kỹ báo cáo tài chính và chiến lược AI cụ thể của từng công ty, không đầu tư theo xu hướng.