Deep Learning cơ bản là phần kiến thức giúp bạn hiểu cách máy tính học từ ảnh, âm thanh và văn bản bằng mạng nơ-ron nhiều lớp. Bạn không cần bắt đầu bằng một mô hình khổng lồ. Điều quan trọng trước tiên là nắm được một vòng huấn luyện: mô hình dự đoán, đo sai số, điều chỉnh trọng số rồi lặp lại.
Bài viết này giải thích Deep Learning theo góc nhìn thực hành dành cho người mới: mối quan hệ với AI và Machine Learning, cách mạng nơ-ron học, các kiến trúc phổ biến, khi nào nên dùng và lộ trình để tự xây mô hình đầu tiên.
Deep Learning là gì?
Deep Learning, hay học sâu, là một nhánh của Machine Learning sử dụng mạng nơ-ron nhân tạo có nhiều lớp xử lý để học biểu diễn từ dữ liệu. Thay vì yêu cầu con người mô tả toàn bộ quy tắc nhận diện, mô hình học cách biến dữ liệu đầu vào thành các biểu diễn ngày càng hữu ích cho nhiệm vụ cần giải quyết.
Ví dụ, với bài toán phân loại ảnh, các lớp đầu có thể phản ứng với cạnh và vùng màu; các lớp sâu hơn kết hợp chúng thành họa tiết, bộ phận và đối tượng. Cách học theo nhiều tầng biểu diễn này là ý tưởng cốt lõi được trình bày trong giáo trình mở Deep Learning của Goodfellow, Bengio và Courville.
AI, Machine Learning và Deep Learning liên quan thế nào?
- Trí tuệ nhân tạo (AI) là phạm vi rộng nhất, bao gồm các hệ thống thực hiện nhiệm vụ thường cần đến trí thông minh của con người.
- Machine Learning (ML) là một hướng tiếp cận trong AI, nơi hệ thống học quy luật từ dữ liệu thay vì chỉ làm theo bộ quy tắc được viết sẵn.
- Deep Learning (DL) là một nhóm phương pháp Machine Learning dựa chủ yếu trên mạng nơ-ron nhiều lớp.
Các trợ lý AI hiện đại như Gemini sử dụng những mô hình Deep Learning rất lớn, nhưng trải nghiệm sử dụng sản phẩm không giống quá trình xây dựng mô hình. Nếu bạn muốn xem một sản phẩm AI được dùng ở góc độ người dùng cuối, có thể đọc hướng dẫn sử dụng Google Gemini AI.
Mạng nơ-ron học như thế nào?
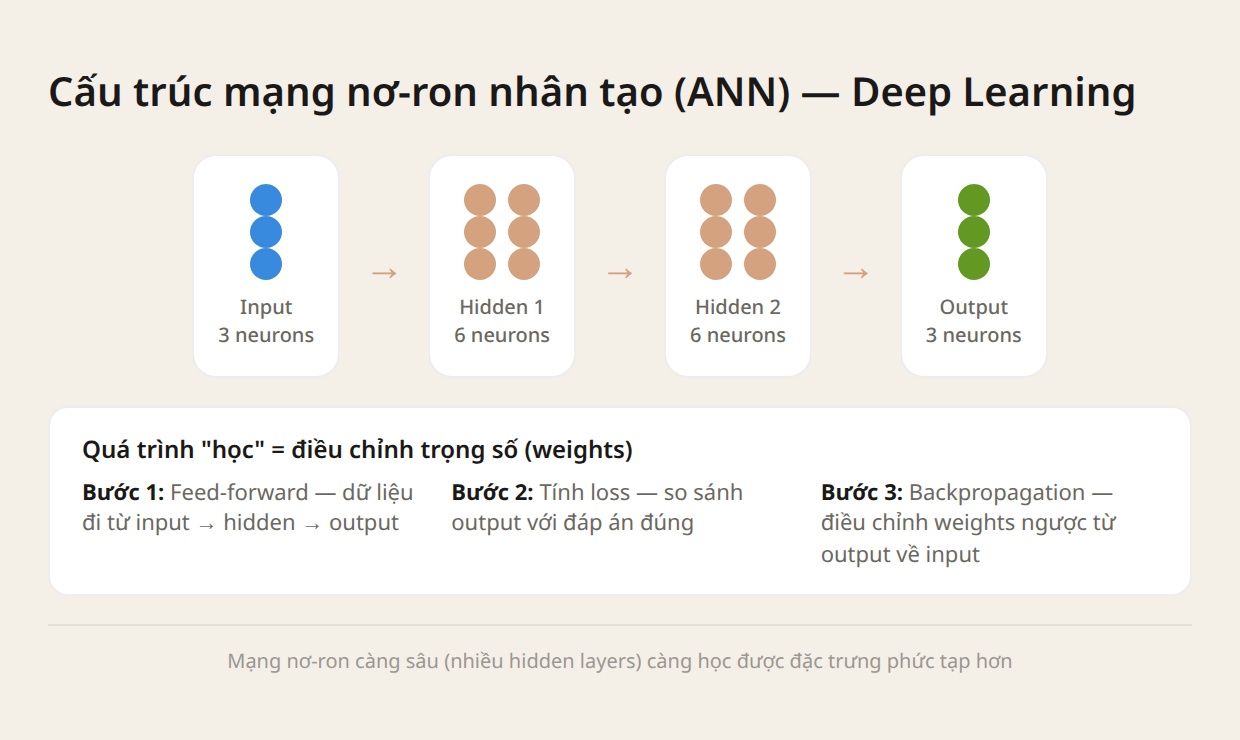
Một mạng nơ-ron có thể được xem như một hàm toán học gồm nhiều lớp nối tiếp nhau. Mỗi lớp nhận một tập số, biến đổi chúng rồi truyền kết quả sang lớp tiếp theo.
- Lớp đầu vào: nhận dữ liệu đã được chuyển thành số, chẳng hạn pixel của ảnh, đặc trưng của một giao dịch hoặc token trong câu.
- Lớp ẩn: kết hợp đầu vào bằng trọng số và độ lệch, sau đó đi qua hàm kích hoạt để học quan hệ phi tuyến.
- Lớp đầu ra: tạo dự đoán phù hợp với bài toán, ví dụ xác suất của từng nhãn hoặc một giá trị liên tục.
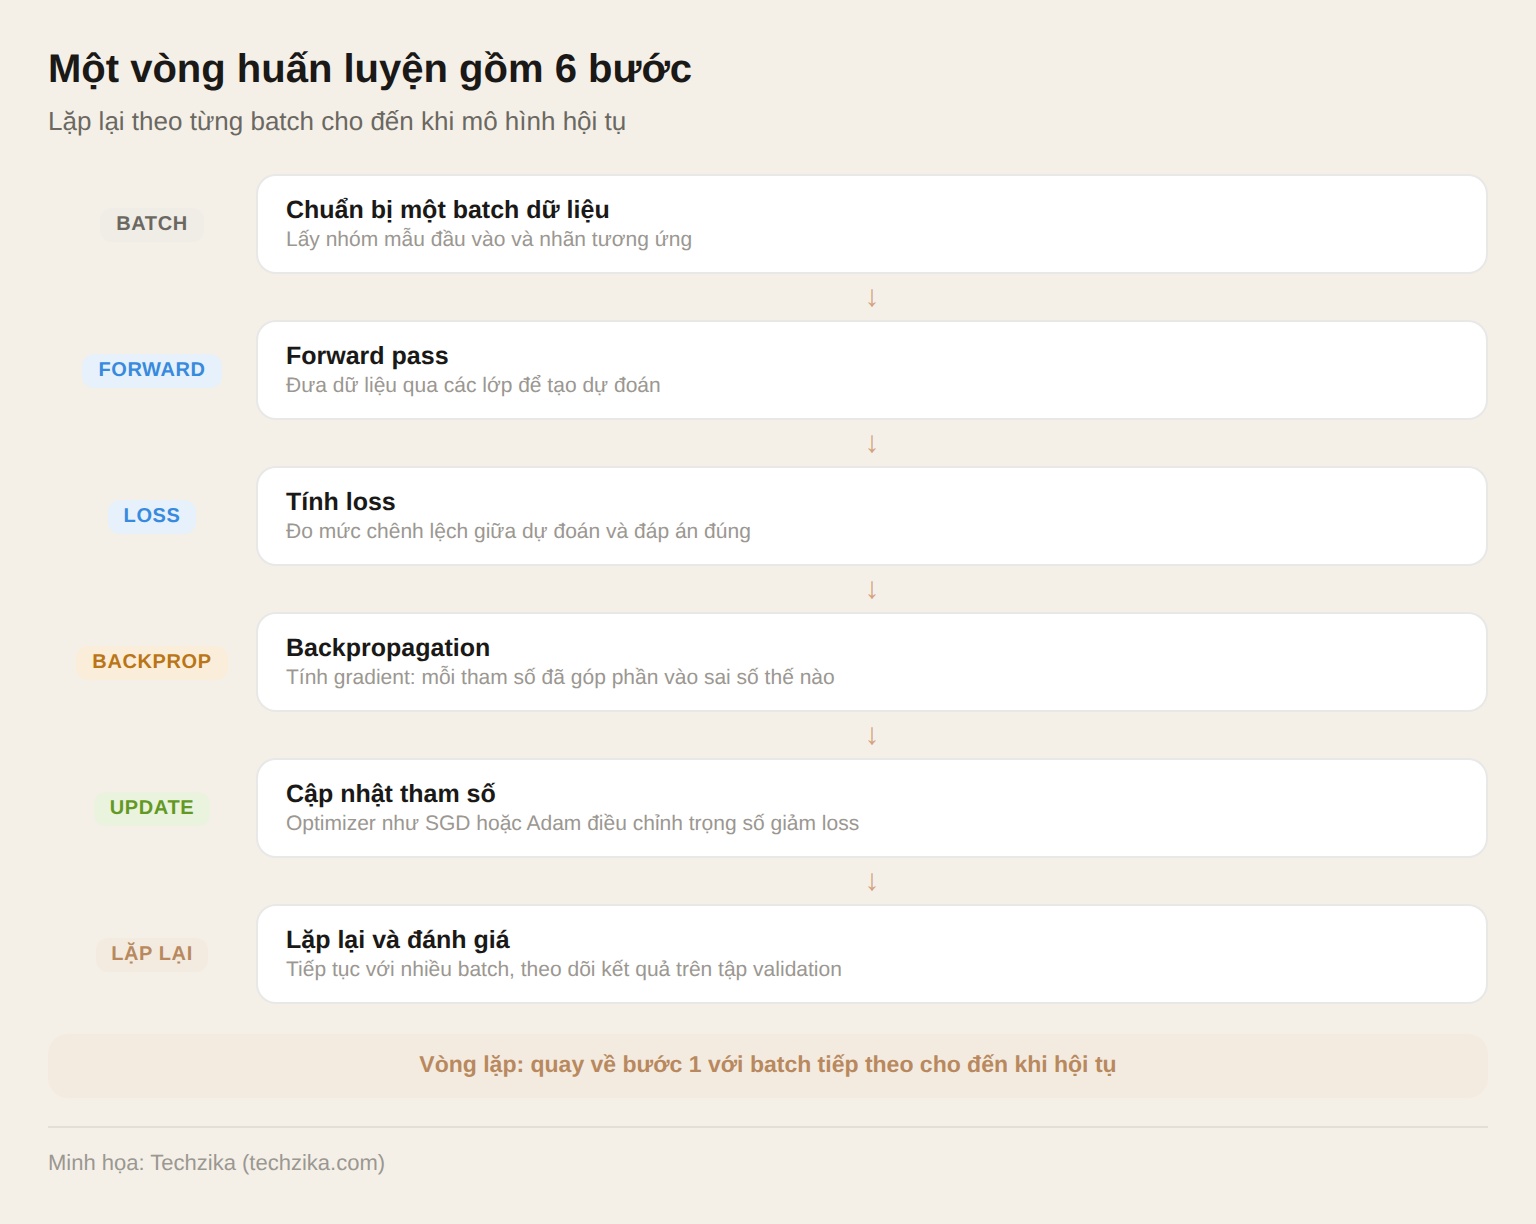
Sáu bước của một vòng huấn luyện
- Chuẩn bị một batch dữ liệu: lấy một nhóm mẫu đầu vào và nhãn tương ứng.
- Forward pass: đưa dữ liệu qua các lớp để tạo dự đoán.
- Tính loss: hàm mất mát đo mức chênh lệch giữa dự đoán và đáp án đúng.
- Backpropagation: tính gradient cho biết mỗi tham số đã góp phần vào sai số như thế nào.
- Cập nhật tham số: optimizer như SGD hoặc Adam điều chỉnh trọng số theo hướng làm giảm loss.
- Lặp lại và đánh giá: tiếp tục với nhiều batch, đồng thời theo dõi kết quả trên tập validation.
Theo Machine Learning Glossary của Google, backpropagation thực hiện việc tính gradient qua các lớp để thuật toán tối ưu có thể điều chỉnh trọng số. Các framework hiện đại tự động hóa phần đạo hàm này, nhưng người học vẫn nên hiểu luồng dữ liệu và ý nghĩa của gradient để chẩn đoán lỗi.
Loss là đại lượng mô hình cố gắng giảm trong lúc huấn luyện. Metric là thước đo bạn dùng để đánh giá, như accuracy hoặc F1-score. Epoch là một lượt mô hình đi qua toàn bộ tập huấn luyện. Loss thấp không tự động có nghĩa mô hình sẽ hoạt động tốt trên dữ liệu mới.
Deep Learning khác Machine Learning truyền thống ở đâu?
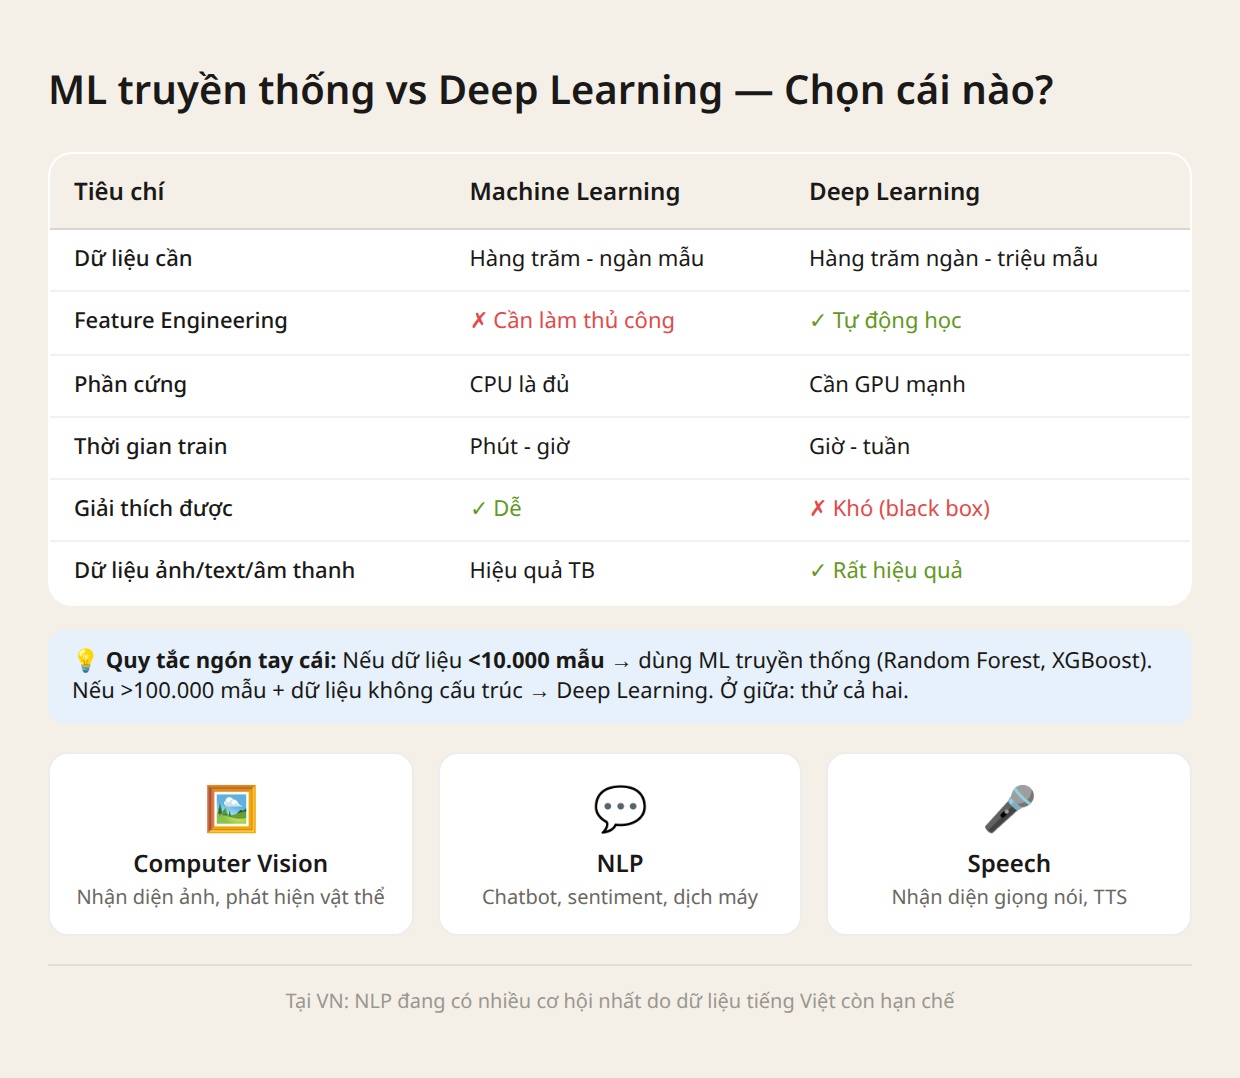
Deep Learning không phải lúc nào cũng tốt hơn các thuật toán Machine Learning khác. Lựa chọn đúng phụ thuộc vào loại dữ liệu, quy mô tập dữ liệu, yêu cầu giải thích và tài nguyên tính toán.
| Tiêu chí | Machine Learning truyền thống | Deep Learning |
|---|---|---|
| Dữ liệu phù hợp | Thường mạnh với dữ liệu dạng bảng và tập dữ liệu nhỏ đến vừa | Đặc biệt hiệu quả với ảnh, âm thanh, văn bản và dữ liệu nhiều chiều |
| Đặc trưng | Thường cần chọn hoặc xây đặc trưng theo hiểu biết miền | Có thể học biểu diễn trực tiếp từ dữ liệu, nhưng vẫn cần chuẩn bị dữ liệu tốt |
| Tài nguyên | Nhiều mô hình chạy tốt trên CPU | Huấn luyện mô hình lớn thường hưởng lợi đáng kể từ GPU hoặc bộ tăng tốc |
| Khả năng giải thích | Một số mô hình như hồi quy và cây quyết định dễ diễn giải hơn | Thường khó giải thích từng quyết định, cần thêm kỹ thuật phân tích |
| Thời gian thử nghiệm | Thường nhanh hơn và có ít siêu tham số hơn | Có thể tốn nhiều thời gian cho huấn luyện, tinh chỉnh và kiểm soát dữ liệu |
| Điểm khởi đầu hợp lý | Baseline cho dữ liệu dạng bảng hoặc khi cần triển khai gọn nhẹ | Khi dữ liệu phức tạp hoặc có mô hình pretrained phù hợp để fine-tune |
Một ngộ nhận phổ biến là Deep Learning luôn cần hàng triệu mẫu. Nếu huấn luyện từ đầu, nhu cầu dữ liệu có thể rất lớn. Tuy nhiên, transfer learning cho phép tái sử dụng mô hình đã được huấn luyện trước và tinh chỉnh trên tập dữ liệu nhỏ hơn. Đây thường là điểm xuất phát thực tế hơn cho người mới và doanh nghiệp nhỏ.
Khi nào chưa nên dùng Deep Learning?
Hãy ưu tiên một mô hình đơn giản hơn nếu dữ liệu chủ yếu là bảng, số mẫu còn ít, quyết định phải giải thích rõ hoặc hệ thống cần chạy trên thiết bị hạn chế. Một baseline như logistic regression, random forest hay gradient boosting vừa nhanh, vừa giúp bạn biết Deep Learning có thực sự tạo ra cải thiện đáng kể hay không.
Quy tắc thực dụng: dưới khoảng 10.000 mẫu thường nên bắt đầu với ML truyền thống; trên khoảng 100.000 mẫu kèm dữ liệu phi cấu trúc là vùng mạnh của Deep Learning; khoảng giữa nên thử cả hai.
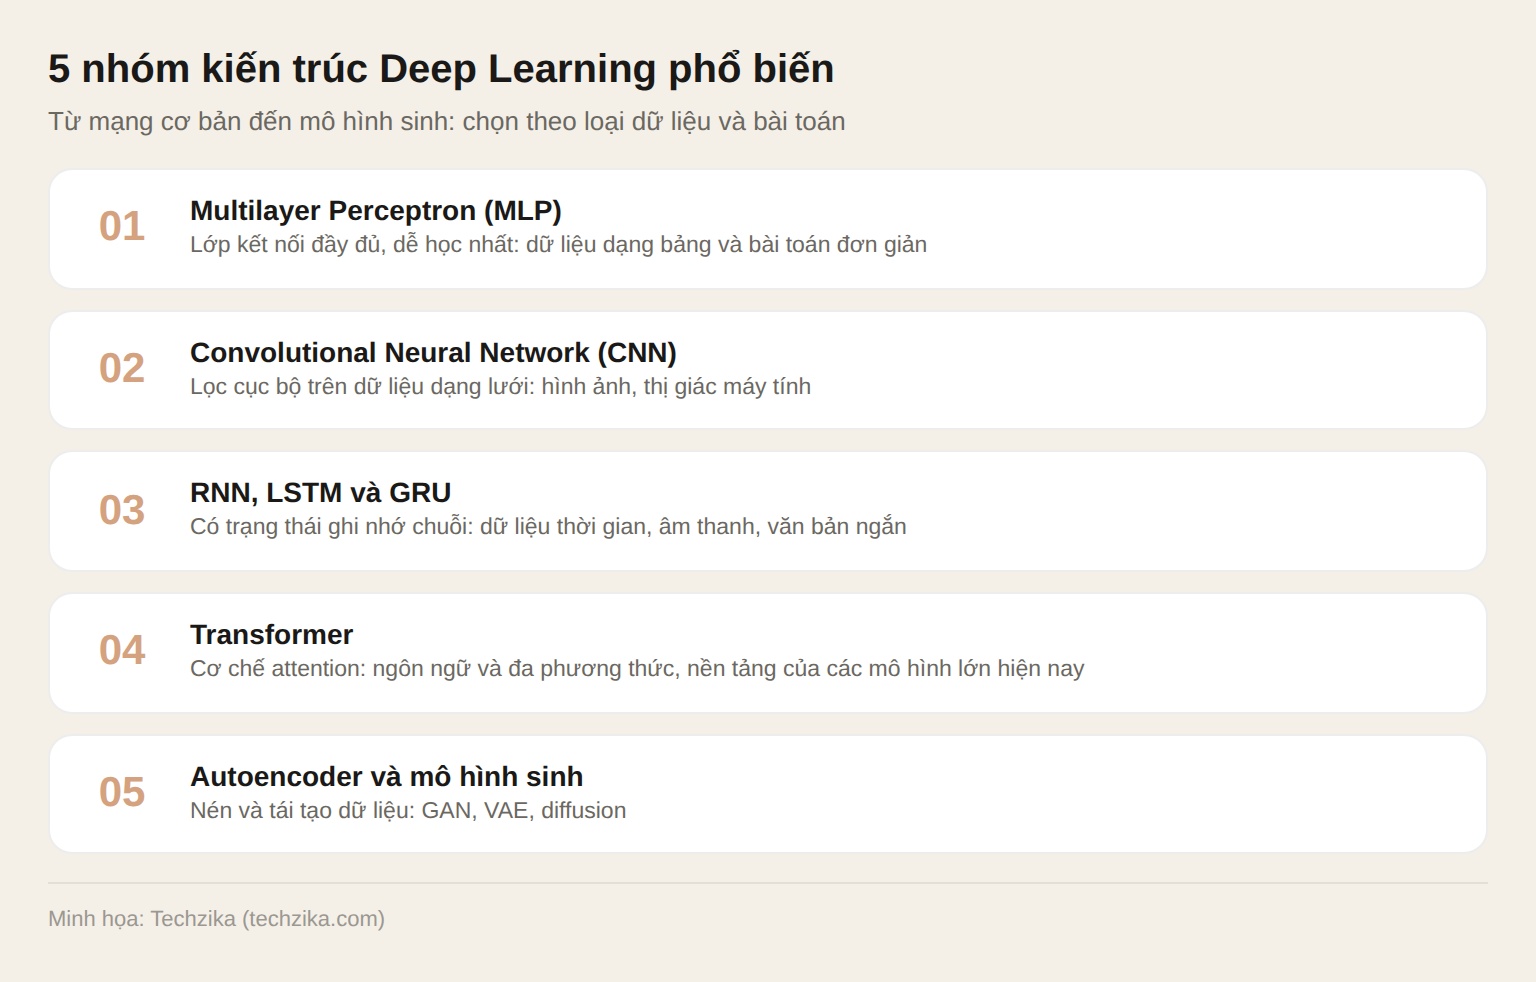
Các kiến trúc Deep Learning phổ biến
Multilayer Perceptron (MLP)
MLP gồm các lớp kết nối đầy đủ và là kiến trúc dễ học nhất để hiểu forward pass, hàm kích hoạt và backpropagation. MLP có thể dùng cho phân loại hoặc hồi quy, nhưng không tận dụng tốt cấu trúc không gian của ảnh hay thứ tự dài trong văn bản.
Convolutional Neural Network (CNN)
CNN sử dụng các bộ lọc để phát hiện mẫu cục bộ như cạnh, họa tiết và hình dạng. Kiến trúc này tạo nền tảng cho nhiều hệ thống xử lý ảnh. CNN vẫn hữu ích trong các bài toán thị giác, đặc biệt khi mô hình cần gọn, nhanh hoặc chạy trên thiết bị biên.
RNN, LSTM và GRU
Mạng hồi tiếp xử lý dữ liệu theo chuỗi và duy trì trạng thái từ các bước trước. LSTM và GRU được thiết kế để giảm khó khăn khi học phụ thuộc dài. Chúng vẫn xuất hiện trong bài toán chuỗi thời gian, âm thanh và hệ thống có yêu cầu độ trễ thấp, dù Transformer đã thay thế chúng trong nhiều tác vụ ngôn ngữ.
Transformer
Transformer sử dụng cơ chế attention để mô hình hóa quan hệ giữa các phần tử trong chuỗi. Bài báo Attention Is All You Need giới thiệu kiến trúc này cho dịch máy và loại bỏ yêu cầu xử lý tuần tự của mạng hồi tiếp trong mô hình gốc. Transformer hiện được dùng rộng rãi cho ngôn ngữ, thị giác, âm thanh và dữ liệu đa phương thức.
Autoencoder và mô hình sinh
Autoencoder học cách nén rồi tái tạo dữ liệu, hữu ích cho giảm chiều, phát hiện bất thường và học biểu diễn. Các họ mô hình sinh như GAN, VAE và diffusion học phân phối dữ liệu để tạo ảnh, âm thanh hoặc các dạng nội dung mới. Đây là chủ đề nên học sau khi đã nắm vững mạng feedforward, tối ưu và đánh giá mô hình.
Deep Learning được dùng vào việc gì?
- Thị giác máy tính: phân loại ảnh, phát hiện vật thể, phân đoạn ảnh và kiểm tra lỗi sản phẩm.
- Xử lý ngôn ngữ: phân loại văn bản, tìm kiếm ngữ nghĩa, tóm tắt, dịch máy và mô hình ngôn ngữ lớn.
- Âm thanh và giọng nói: chuyển giọng nói thành văn bản, tổng hợp giọng nói, tách nguồn âm và nhận diện sự kiện âm thanh.
- Hệ gợi ý: học biểu diễn người dùng và nội dung để xếp hạng sản phẩm, bài viết hoặc video.
- Phát hiện bất thường: nhận diện giao dịch, tín hiệu cảm biến hoặc hành vi khác với mẫu bình thường.
- Tự động hóa: trích xuất thông tin từ tài liệu, phân loại yêu cầu và hỗ trợ các quy trình có dữ liệu phi cấu trúc. Bạn có thể xem thêm các ví dụ trong bài AI và tự động hóa.
Một ứng dụng có thể kết hợp nhiều mô hình, luật nghiệp vụ và bước kiểm tra của con người. Vì vậy, Deep Learning chỉ là một thành phần trong hệ thống hoàn chỉnh, không phải toàn bộ sản phẩm.
Quy trình xây một mô hình Deep Learning
- Xác định bài toán và metric: mô tả đầu vào, đầu ra, chi phí của từng loại sai và điều kiện thành công.
- Thu thập và kiểm tra dữ liệu: tìm nhãn sai, dữ liệu trùng, mất cân bằng và thông tin nhạy cảm.
- Chia dữ liệu: tách train, validation và test trước khi thử nghiệm để hạn chế rò rỉ dữ liệu.
- Tạo baseline: dùng quy tắc đơn giản hoặc mô hình ML nhẹ để có mốc so sánh.
- Chọn mô hình: ưu tiên kiến trúc nhỏ hoặc mô hình pretrained phù hợp với dữ liệu.
- Huấn luyện và theo dõi: ghi lại loss, metric, cấu hình, seed và phiên bản dữ liệu.
- Đánh giá lỗi: xem từng nhóm dự đoán sai, không chỉ nhìn vào một điểm số trung bình.
- Triển khai và giám sát: theo dõi độ trễ, chi phí, dữ liệu thay đổi và chất lượng sau triển khai.
Bước tạo baseline đặc biệt quan trọng. Nếu một mô hình đơn giản đã đạt yêu cầu, mô hình Deep Learning phức tạp hơn có thể không đáng với chi phí vận hành và bảo trì.
Lộ trình học Deep Learning cơ bản cho người mới
Lộ trình dưới đây có thể kéo dài hoặc rút ngắn tùy nền tảng. Mục tiêu không phải hoàn thành thật nhanh, mà là tạo được một chuỗi kiến thức liền mạch từ dữ liệu đến đánh giá mô hình.
| Giai đoạn | Nội dung chính | Sản phẩm nên hoàn thành |
|---|---|---|
| 1. Python và dữ liệu | Python, NumPy, cách đọc dữ liệu, shape, dtype và vector hóa | Một notebook làm sạch và trực quan hóa tập dữ liệu nhỏ |
| 2. Nền tảng Machine Learning | Train/validation/test, loss, gradient descent, overfitting và metric | Một mô hình baseline và báo cáo đánh giá lỗi |
| 3. Mạng nơ-ron đầu tiên | Layer, activation, forward pass, backpropagation và optimizer | MLP phân loại Fashion-MNIST hoặc bài toán tương đương |
| 4. Chọn một hướng | CNN cho ảnh hoặc Transformer pretrained cho văn bản | Một project có dữ liệu, thí nghiệm và kết quả tái lập được |
| 5. Đưa vào sử dụng | Lưu mô hình, tạo API hoặc ứng dụng thử nghiệm, đo độ trễ | Demo nhỏ kèm README nêu giới hạn của mô hình |
Cần học toán đến mức nào?
Để bắt đầu, bạn cần hiểu vector, ma trận, đạo hàm, xác suất cơ bản và ý nghĩa của gradient. Bạn chưa cần chứng minh mọi công thức. Hãy học toán song song với bài thực hành: khi gặp tensor shape, học lại đại số tuyến tính; khi gặp optimizer, học đạo hàm và gradient; khi đánh giá mô hình, học xác suất và thống kê.
Nên chọn PyTorch hay TensorFlow?
Cả hai đều đủ khả năng để học và làm sản phẩm. Chọn một framework rồi theo đến hết project đầu tiên. PyTorch 60 Minute Blitz hướng dẫn tensor, autograd, mạng nơ-ron và bộ phân loại. TensorFlow Quickstart for Beginners đi từ dữ liệu đến xây, train và đánh giá mô hình Keras. Việc đổi framework quá sớm thường làm chậm quá trình học hơn là giúp mở rộng kiến thức.
Ba project phù hợp để bắt đầu
- Phân loại ảnh quần áo: xây MLP làm baseline, sau đó thử CNN và so sánh lỗi.
- Phân loại văn bản tiếng Việt: fine-tune một encoder pretrained, chú ý mất cân bằng nhãn và dữ liệu trùng.
- Phát hiện bất thường: dùng autoencoder hoặc mô hình baseline trên dữ liệu cảm biến, sau đó đánh giá precision và recall.
Mỗi project nên có mô tả dữ liệu, cách chia tập, metric, các thí nghiệm đã thử và phân tích trường hợp dự đoán sai. Một repository nhỏ nhưng tái lập được có giá trị học tập cao hơn nhiều notebook sao chép mà bạn không giải thích được.
Những lỗi người mới thường gặp
- Rò rỉ dữ liệu: thông tin từ validation hoặc test vô tình đi vào quá trình huấn luyện, khiến điểm số cao giả tạo.
- Chỉ theo dõi accuracy: với dữ liệu mất cân bằng, accuracy có thể che giấu việc mô hình bỏ sót nhóm quan trọng.
- Không có baseline: bạn không biết mô hình phức tạp có thực sự tốt hơn giải pháp đơn giản hay không.
- Model lớn hơn dữ liệu: mô hình ghi nhớ tập train nhưng hoạt động kém trên dữ liệu mới.
- Tinh chỉnh quá nhiều trên test set: test set không còn là phép kiểm tra độc lập.
- Không lưu cấu hình: thiếu seed, phiên bản dữ liệu và siêu tham số khiến kết quả không tái lập được.
- Bỏ qua dữ liệu sai: nhiều vấn đề hiệu suất đến từ nhãn, tiền xử lý hoặc cách lấy mẫu chứ không phải kiến trúc.
Hãy kiểm tra một batch thật nhỏ trước: nhãn có đúng không, tensor có đúng shape không, đầu ra có phù hợp với loss không và learning rate có quá lớn hay quá nhỏ không. Sau đó thử cho mô hình ghi nhớ vài chục mẫu. Nếu vẫn không thể overfit tập nhỏ, lỗi thường nằm trong pipeline hoặc cách cài đặt.
Google có phần riêng về backpropagation và các vấn đề khi huấn luyện mạng nơ-ron, gồm vanishing gradient, exploding gradient, ReLU và dropout. Đây là tài liệu phù hợp để đối chiếu khi bạn bắt đầu debug.
Giới hạn và rủi ro cần biết
Deep Learning có thể học mẫu sai lệch từ dữ liệu, tạo dự đoán khó giải thích và suy giảm chất lượng khi dữ liệu thực tế khác dữ liệu huấn luyện. Mô hình lớn còn có chi phí tính toán, năng lượng và vận hành đáng kể. Với dữ liệu cá nhân hoặc quyết định ảnh hưởng đến con người, cần đánh giá quyền riêng tư, thiên lệch, bảo mật và cơ chế để con người kiểm tra kết quả.
Trong sản phẩm thực tế, nên đặt ngưỡng tin cậy, ghi log, theo dõi dữ liệu thay đổi và có phương án xử lý khi mô hình không chắc chắn. Đối với quy trình tự động, các bước có hậu quả lớn vẫn cần phê duyệt của con người. Bài AI Agent là gì giải thích thêm cách mô hình, công cụ và lớp kiểm soát phối hợp trong một hệ thống tự động.
Kết luận
Muốn học Deep Learning cơ bản, bạn nên bắt đầu từ vòng huấn luyện và dữ liệu thay vì chạy theo mô hình mới nhất. Hãy xây một baseline, hiểu forward pass, loss và backpropagation, rồi hoàn thành một project nhỏ bằng PyTorch hoặc TensorFlow. Khi đã phân tích được lỗi và tái lập kết quả, bạn mới cần mở rộng sang CNN, Transformer, mô hình sinh hoặc triển khai production.
Câu hỏi thường gặp
Deep Learning có phải là AI không?
Có. Deep Learning là một nhóm phương pháp trong Machine Learning, còn Machine Learning là một nhánh của AI. Không phải mọi hệ thống AI đều dùng Deep Learning.
Deep Learning và Machine Learning khác nhau thế nào?
Deep Learning dùng mạng nơ-ron nhiều lớp và thường tự học biểu diễn từ dữ liệu phức tạp. Machine Learning truyền thống bao gồm nhiều thuật toán khác như hồi quy, cây quyết định và gradient boosting, thường phù hợp với dữ liệu dạng bảng hoặc yêu cầu giải thích rõ.
Có cần GPU để học Deep Learning không?
Không cần GPU cho những bài đầu tiên và mô hình nhỏ. GPU giúp huấn luyện CNN, Transformer hoặc tập dữ liệu lớn nhanh hơn. Người mới có thể dùng CPU trước, sau đó dùng notebook đám mây hoặc GPU khi project thực sự cần.
Người mới nên học PyTorch hay TensorFlow?
Hãy chọn framework có tài liệu và cộng đồng phù hợp với mục tiêu của bạn. PyTorch thường trực quan khi học và thử nghiệm; TensorFlow/Keras có luồng bắt đầu gọn và hệ sinh thái triển khai rộng. Quan trọng nhất là hoàn thành trọn vẹn một project trước khi đổi framework.
Học Deep Learning mất bao lâu?
Không có mốc cố định. Nếu đã biết Python và Machine Learning, bạn có thể hiểu nền tảng và làm project nhỏ sau vài tuần học đều. Để tự thiết kế thí nghiệm, debug và triển khai đáng tin cậy thường cần nhiều tháng thực hành liên tục.
Sau Deep Learning cơ bản nên học gì?
Hãy chọn một hướng theo loại dữ liệu bạn quan tâm: computer vision, NLP, âm thanh, chuỗi thời gian hoặc hệ gợi ý. Tiếp theo, học transfer learning, đánh giá lỗi, quản lý thí nghiệm và triển khai mô hình thay vì chỉ tiếp tục sưu tầm kiến trúc.
Đọc tiếp trong cụm AI: Khi đã nắm nền tảng mô hình, bạn có thể xem Ollama và AI local để thử chạy model trên máy cá nhân, hoặc đọc AI Agent là gì để hiểu cách kết nối model với công cụ và quy trình.