RAG là gì? Định nghĩa và cơ chế hoạt động
RAG (Retrieval-Augmented Generation) là kỹ thuật kết hợp tìm kiếm thông tin với sinh văn bản, cho phép AI vừa “tra cứu” dữ liệu bên ngoài vừa tạo câu trả lời, thay vì chỉ dựa vào kiến thức đã học từ trước.
Hãy hình dung thế này: Một LLM thông thường giống như học sinh đi thi với trí nhớ của mình. Nó chỉ trả lời được những gì đã “học”. Còn LLM có RAG giống như học sinh được mang sách vào phòng thi. Khi gặp câu hỏi khó, nó mở sách, tìm trang liên quan, đọc, rồi mới trả lời.
Điểm khác biệt cốt lõi: RAG tách biệt “kiến thức nền” khỏi “kiến thức tra cứu”. Model vẫn có khả năng suy luận và viết, nhưng thông tin thực tế được lấy từ nguồn bên ngoài. Nhờ vậy, câu trả lời chính xác hơn và luôn cập nhật.
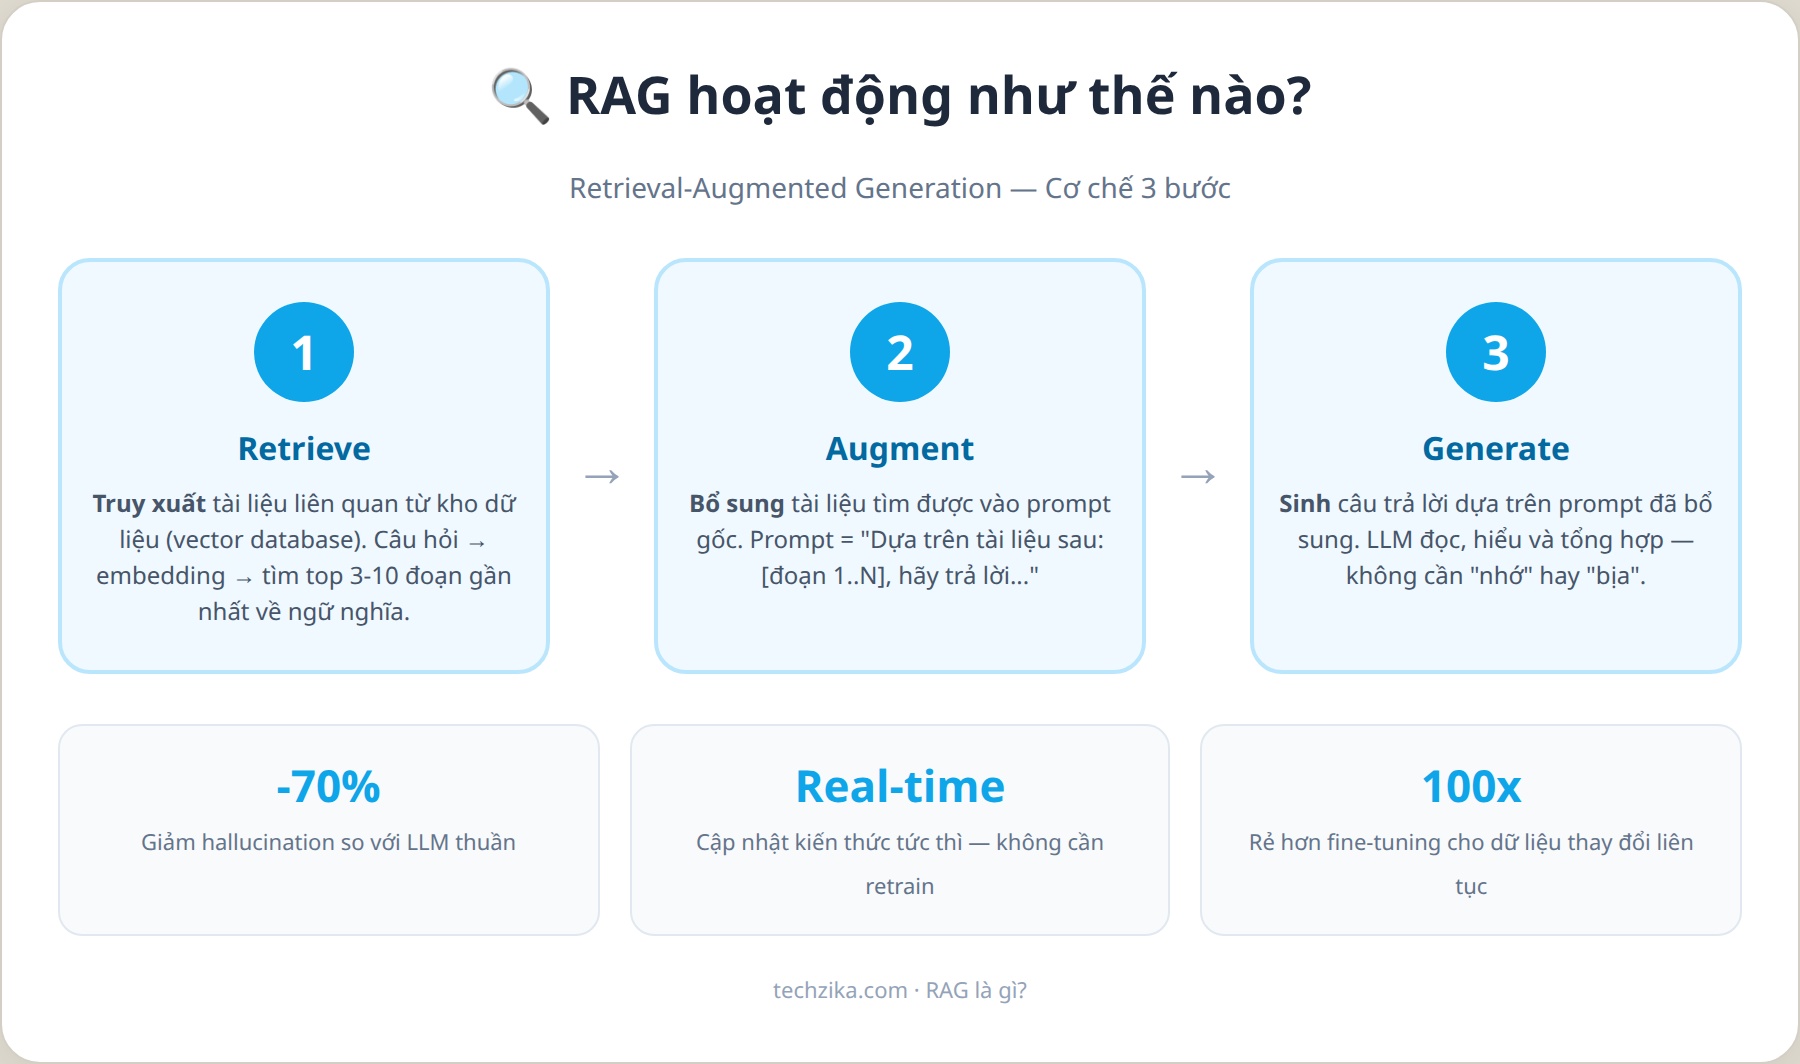
Retrieve (Truy xuất): Tìm tài liệu liên quan từ kho dữ liệu.
Augment (Bổ sung): Ghép tài liệu vào prompt gửi cho LLM.
Generate (Sinh): LLM tạo câu trả lời dựa trên prompt đã bổ sung.
RAG trở nên rất quan trọng trong bối cảnh doanh nghiệp muốn dùng AI với dữ liệu nội bộ. Bạn có hàng nghìn tài liệu PDF, policy, hợp đồng. Không thể huấn luyện lại model mỗi lần có tài liệu mới. RAG cho phép AI đọc và trả lời từ chính kho dữ liệu của bạn, theo thời gian thực.
Thị trường RAG toàn cầu được dự báo tăng từ 2,5 tỷ USD (2025) lên 64,6 tỷ USD (2035), với CAGR 38,6% (Global Insight Services, 4/2026). Lý do cốt lõi: LLM thuần vẫn “ảo giác” khoảng 28,6% câu trả lời, còn RAG giúp giảm hallucination 70-90% nhờ dẫn nguồn dữ liệu thực tế tại thời điểm truy vấn (Synvestable, 2026). Gartner cũng khuyến nghị doanh nghiệp ưu tiên đầu tư RAG khi áp dụng genAI lên dữ liệu riêng của mình.
RAG hoạt động như thế nào? Kiến trúc chi tiết
Quy trình RAG chuẩn gồm 4 bước. Mỗi bước là một mảnh ghép không thể thiếu, và theo tôi, bước quyết định thành bại của cả hệ thống nằm ở bước đầu tiên: chunking và embedding.
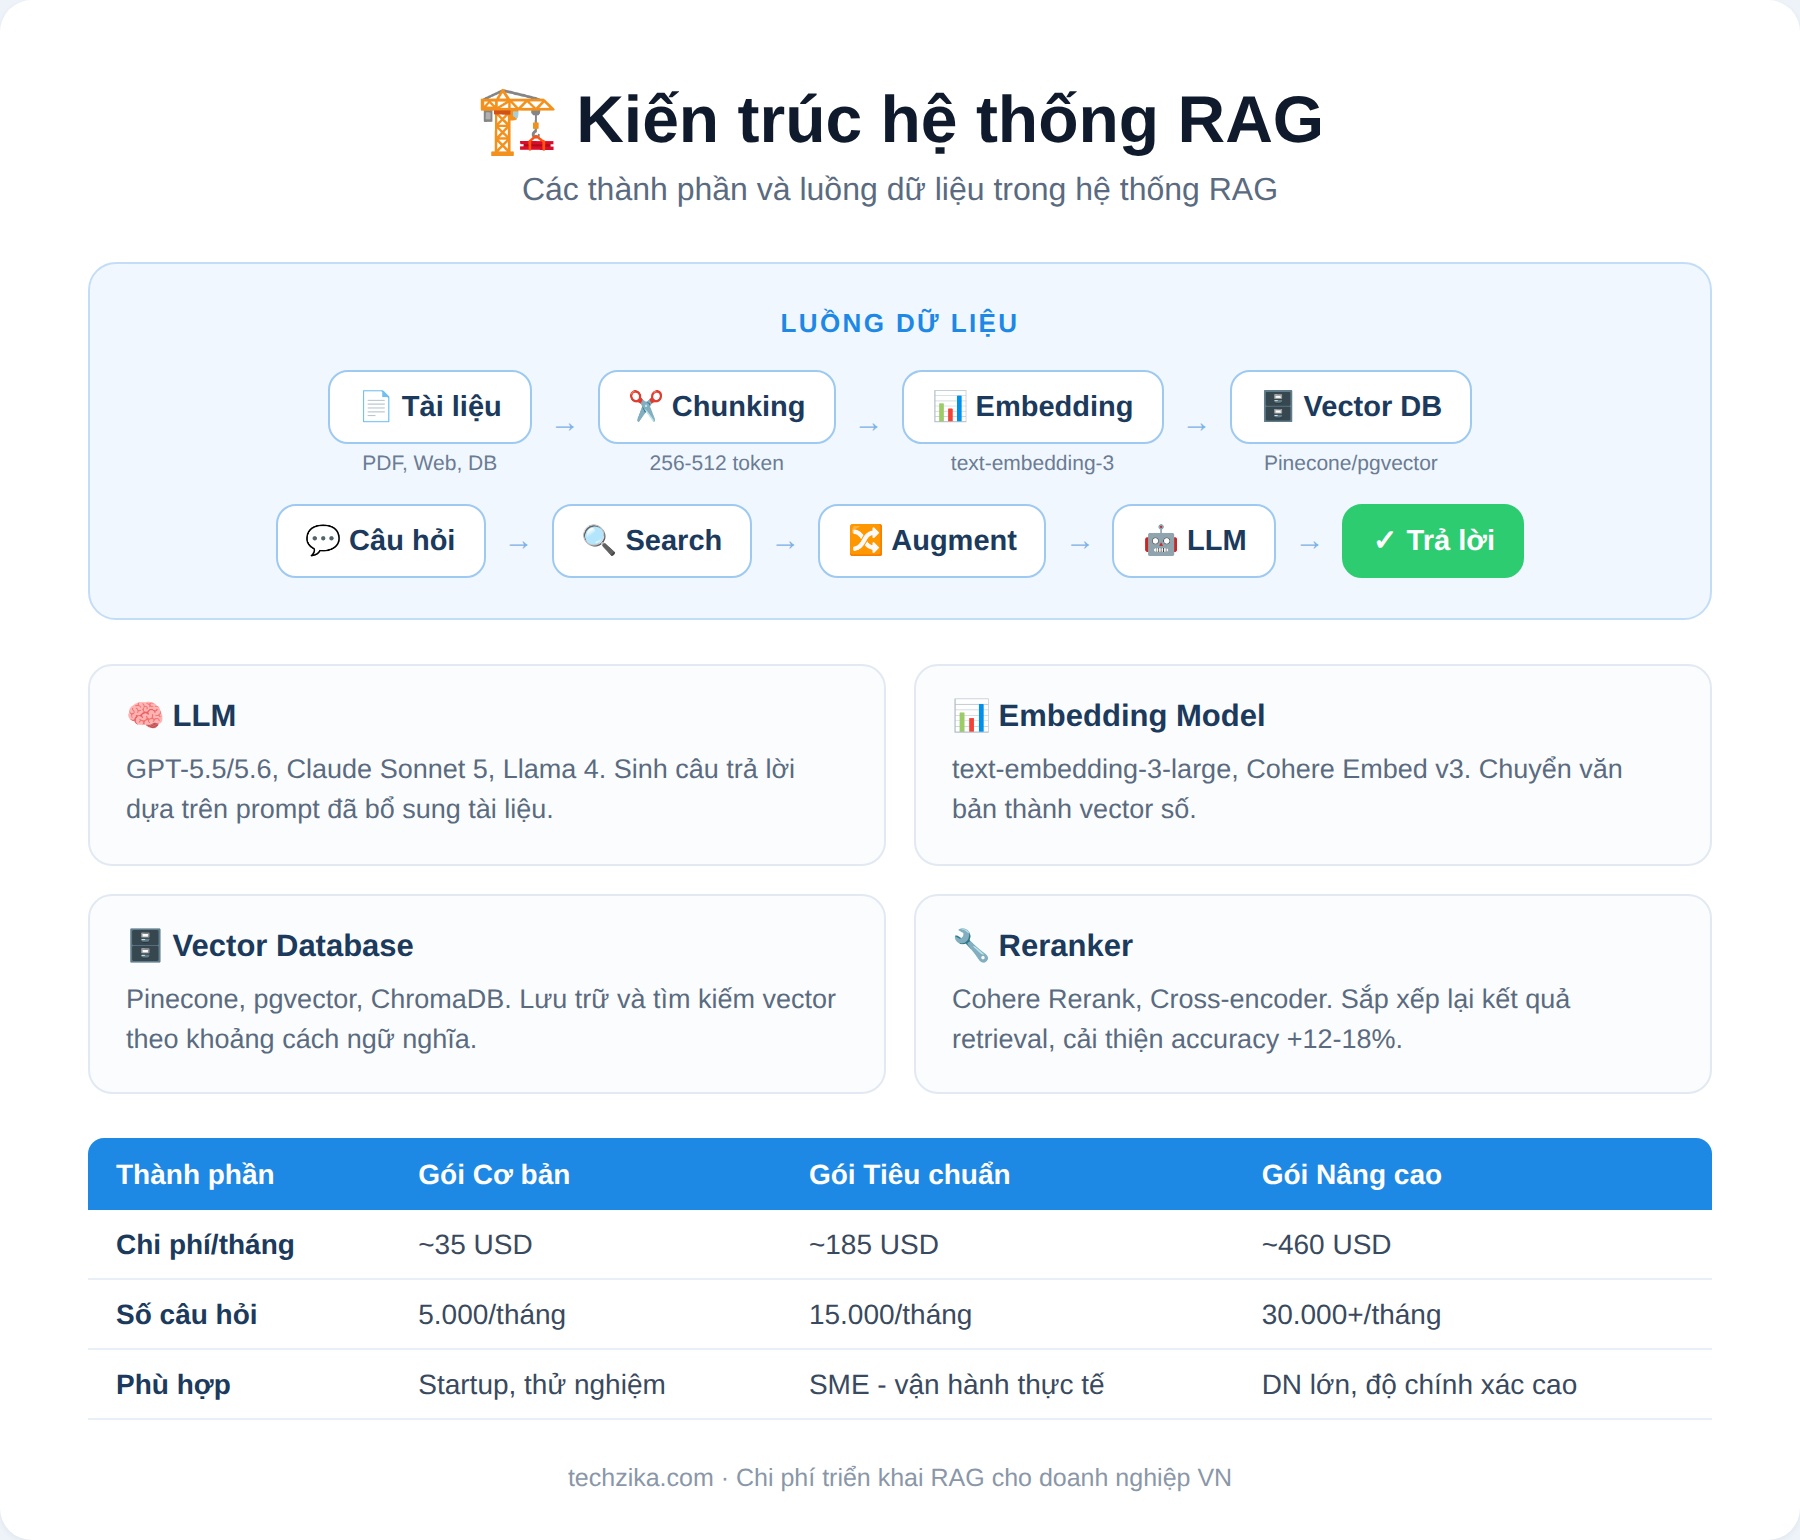
Bước 1: Chunking và Embedding. Tài liệu của bạn (PDF, web, database) được cắt thành các đoạn nhỏ (chunk), mỗi đoạn vài trăm từ. Các đoạn này được chuyển thành vector số (embedding) và lưu vào vector database như Pinecone, Weaviate, hoặc pgvector. Kích thước chunk lý tưởng là 256-512 token cho văn bản tiếng Việt, nhỏ hơn tiếng Anh vì mỗi từ tiếng Việt mang nhiều thông tin hơn.
Tôi thấy nhiều đội ngũ kỹ thuật tại Việt Nam mất quá nhiều thời gian vào việc chọn model mà quên mất chunking strategy. Theo kinh nghiệm của tôi, chunk 256-384 token với overlap 10-15% là điểm khởi đầu tốt nhất cho tiếng Việt, trước khi tinh chỉnh thêm.
Bước 2: Truy vấn và Retrieval. Khi người dùng đặt câu hỏi, câu hỏi cũng được chuyển thành vector. Hệ thống tìm trong vector database những đoạn văn bản có vector gần nhất với vector câu hỏi. Kết quả là top 3-10 đoạn liên quan nhất.
Bước 3: Augment prompt. Các đoạn văn bản tìm được được chèn vào prompt cùng với câu hỏi gốc. Prompt lúc này có dạng: “Dựa trên các tài liệu sau: [đoạn 1] [đoạn 2] [đoạn 3], hãy trả lời câu hỏi: [câu hỏi]”.
Bước 4: Generate. LLM nhận prompt đã bổ sung và sinh câu trả lời. Vì có sẵn thông tin trong prompt, model không cần “nhớ” hay “bịa”. Nó chỉ cần đọc hiểu và tổng hợp.
Đây là loại database chuyên lưu trữ vector (mảng số). Khi tìm kiếm, nó không so khớp từ khóa như SQL, mà tính khoảng cách toán học giữa các vector. “Chó” và “mèo” có vector gần nhau hơn “chó” và “ô tô”. Nhờ vậy, RAG tìm được thông tin liên quan về mặt ngữ nghĩa, không chỉ về mặt từ vựng.
RAG Benchmark: So sánh hiệu suất các phương pháp
Không phải RAG nào cũng giống nhau. Có ít nhất 5 biến thể chính, mỗi loại phù hợp với một bài toán khác nhau. Dưới đây là bảng so sánh dựa trên dữ liệu thu thập từ các paper và benchmark thực tế năm 2025-2026:
| Phương pháp RAG | Độ chính xác | Chi phí/tháng* | Độ trễ | Phù hợp |
|---|---|---|---|---|
| Naive RAG (tìm đơn giản) | 65-72% | $50-100 | 1-2s | FAQ, knowledge base nhỏ |
| Advanced RAG (pre-retrieval + rerank) | 78-85% | $150-300 | 2-4s | Hỗ trợ khách hàng |
| Modular RAG (agent-based) | 82-90% | $300-800 | 3-6s | Phân tích pháp lý, tài chính |
| Graph RAG (đồ thị tri thức) | 85-92% | $500-1500 | 5-10s | Nghiên cứu KH, phân tích đa nguồn |
| Self-RAG (tự kiểm tra chất lượng) | 88-94% | $200-500 | 3-5s | Y tế, giáo dục (cần độ chính xác cao) |
*Chi phí ước tính cho 10.000 câu hỏi/tháng, dùng GPT-5.5 Instant + vector DB.
Theo tôi, doanh nghiệp Việt Nam không nên bắt đầu với Graph RAG hay Self-RAG ngay. Chúng mạnh nhưng phức tạp và đắt. Một Advanced RAG với reranking đơn giản thường là điểm ngọt (sweet spot) cho hầu hết use case: chi phí hợp lý, độ chính xác chấp nhận được, và dễ vận hành.
RAG vs Fine-tuning: Chọn phương pháp nào?
Đây là câu hỏi tôi nhận được nhiều nhất từ các doanh nghiệp. Câu trả lời ngắn: không phải chọn một trong hai. Hầu hết hệ thống sản xuất mạnh mẽ nhất đều kết hợp cả hai. Nhưng để hiểu bản chất, đây là so sánh chi tiết:
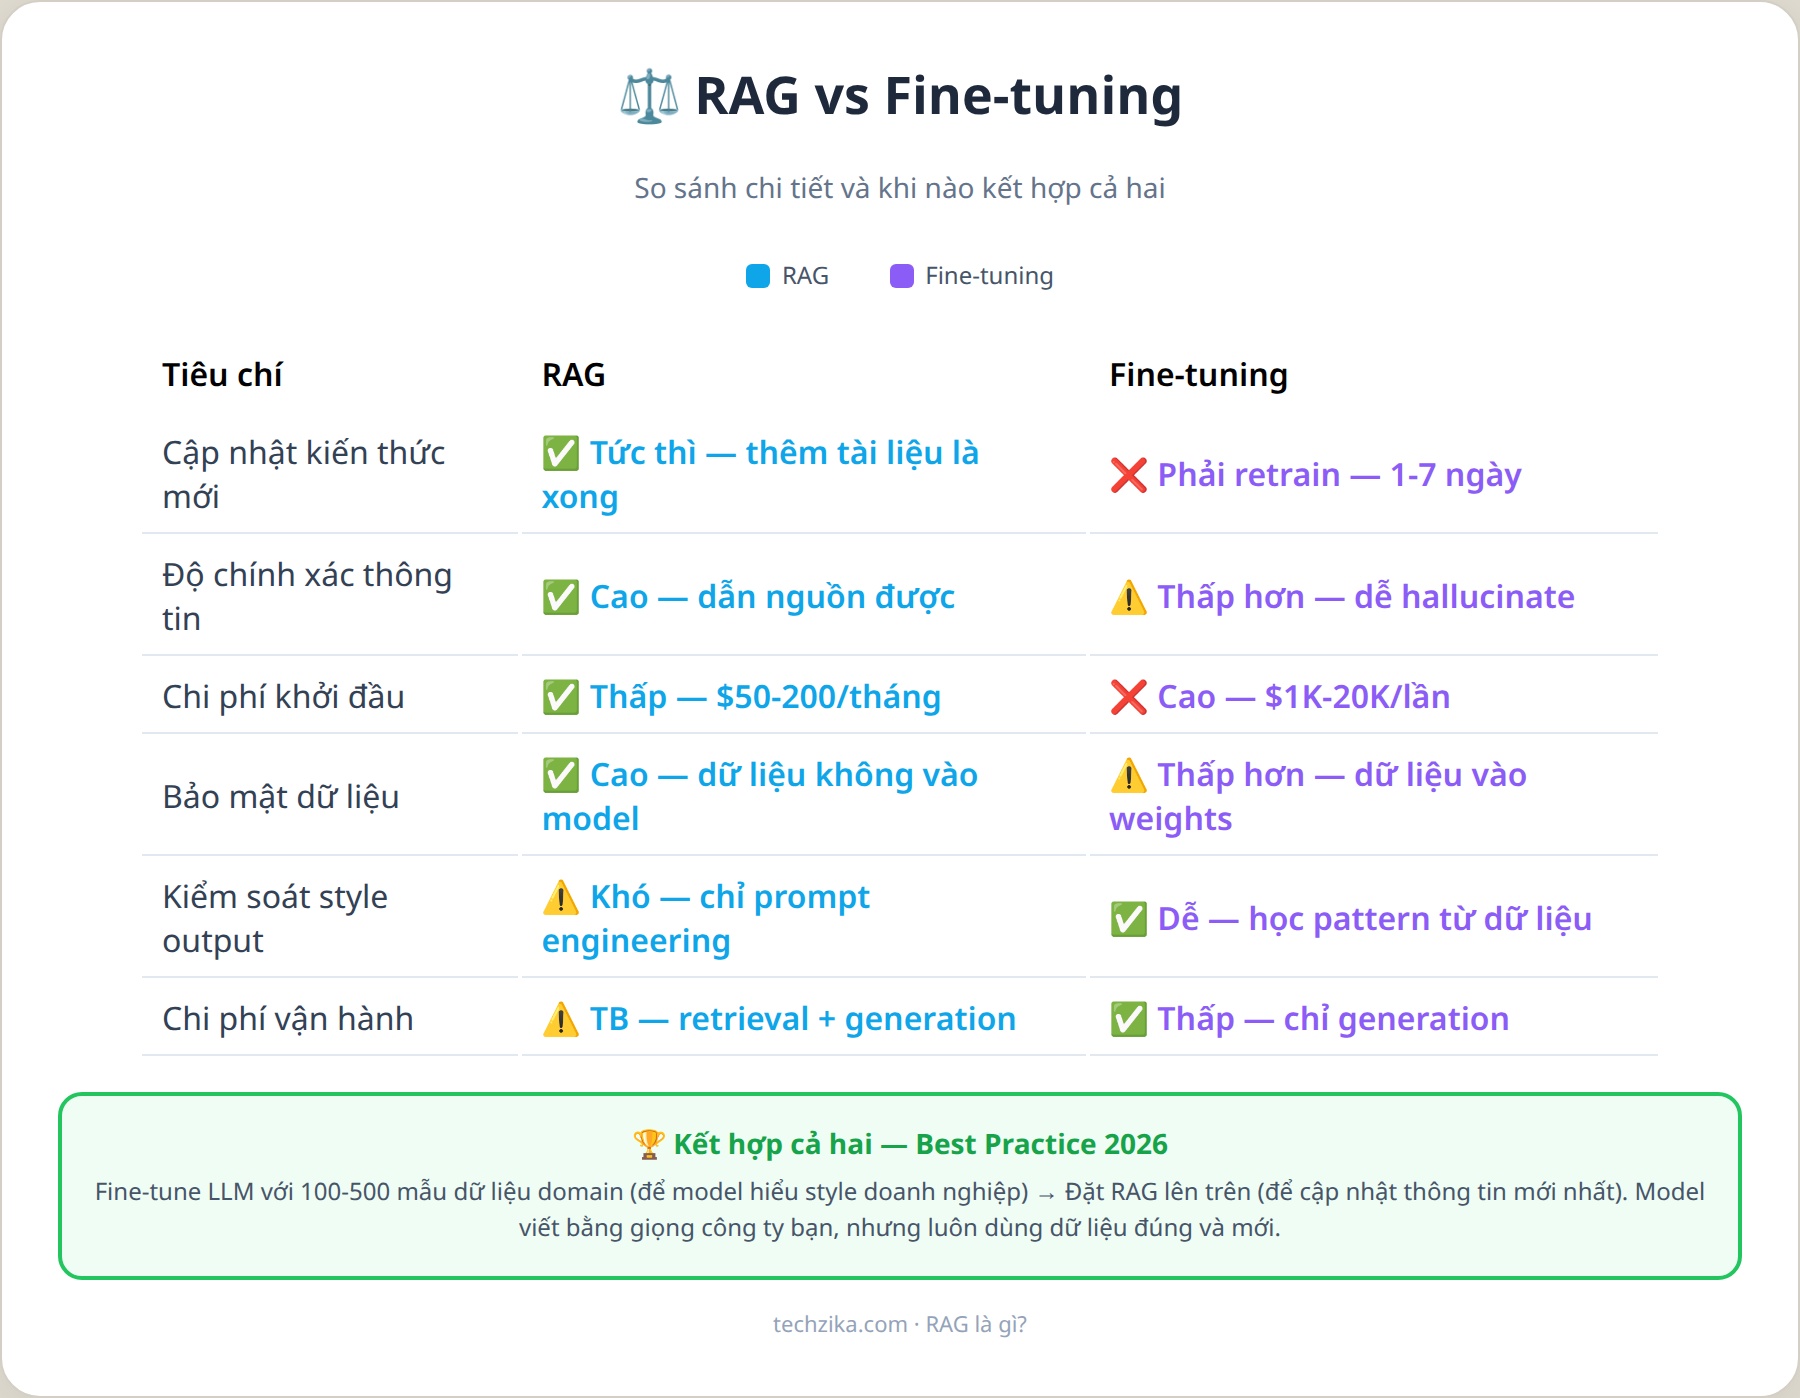
| Tiêu chí | RAG | Fine-tuning |
|---|---|---|
| Nguồn thông tin | Kho dữ liệu ngoài (tra cứu real-time) | Dữ liệu đã huấn luyện (fixed) |
| Cập nhật kiến thức mới | Thêm tài liệu → tức thì | Phải huấn luyện lại → 1-7 ngày |
| Độ chính xác thông tin | Cao (dẫn nguồn được) | Thấp hơn (dễ quên/hallucinate) |
| Kiểm soát style/form | Khó (dùng prompt engineering) | Dễ (học được pattern từ dữ liệu) |
| Chi phí khởi đầu | Thấp ($50-200/tháng) | Cao ($1.000-20.000/lần) |
| Chi phí vận hành | Trung bình (tốn retrieval + generation) | Thấp (chỉ generation) |
| Độ phức tạp | Trung bình (cần pipeline retrieval) | Cao (cần data pipeline + GPU) |
| Bảo mật dữ liệu | Cao (dữ liệu không vào model) | Thấp hơn (dữ liệu đi vào model weights) |
Kịch bản phổ biến nhất năm 2026: fine-tune LLM với 100-500 mẫu dữ liệu domain (để model hiểu ngữ cảnh và style doanh nghiệp), sau đó đặt RAG lên trên để cập nhật thông tin mới nhất. Cách này cho kết quả tốt nhất: model viết “bằng giọng” của công ty bạn, nhưng luôn dùng dữ liệu đúng và mới nhất.
Case study: Chatbot tư vấn tài chính VN với RAG
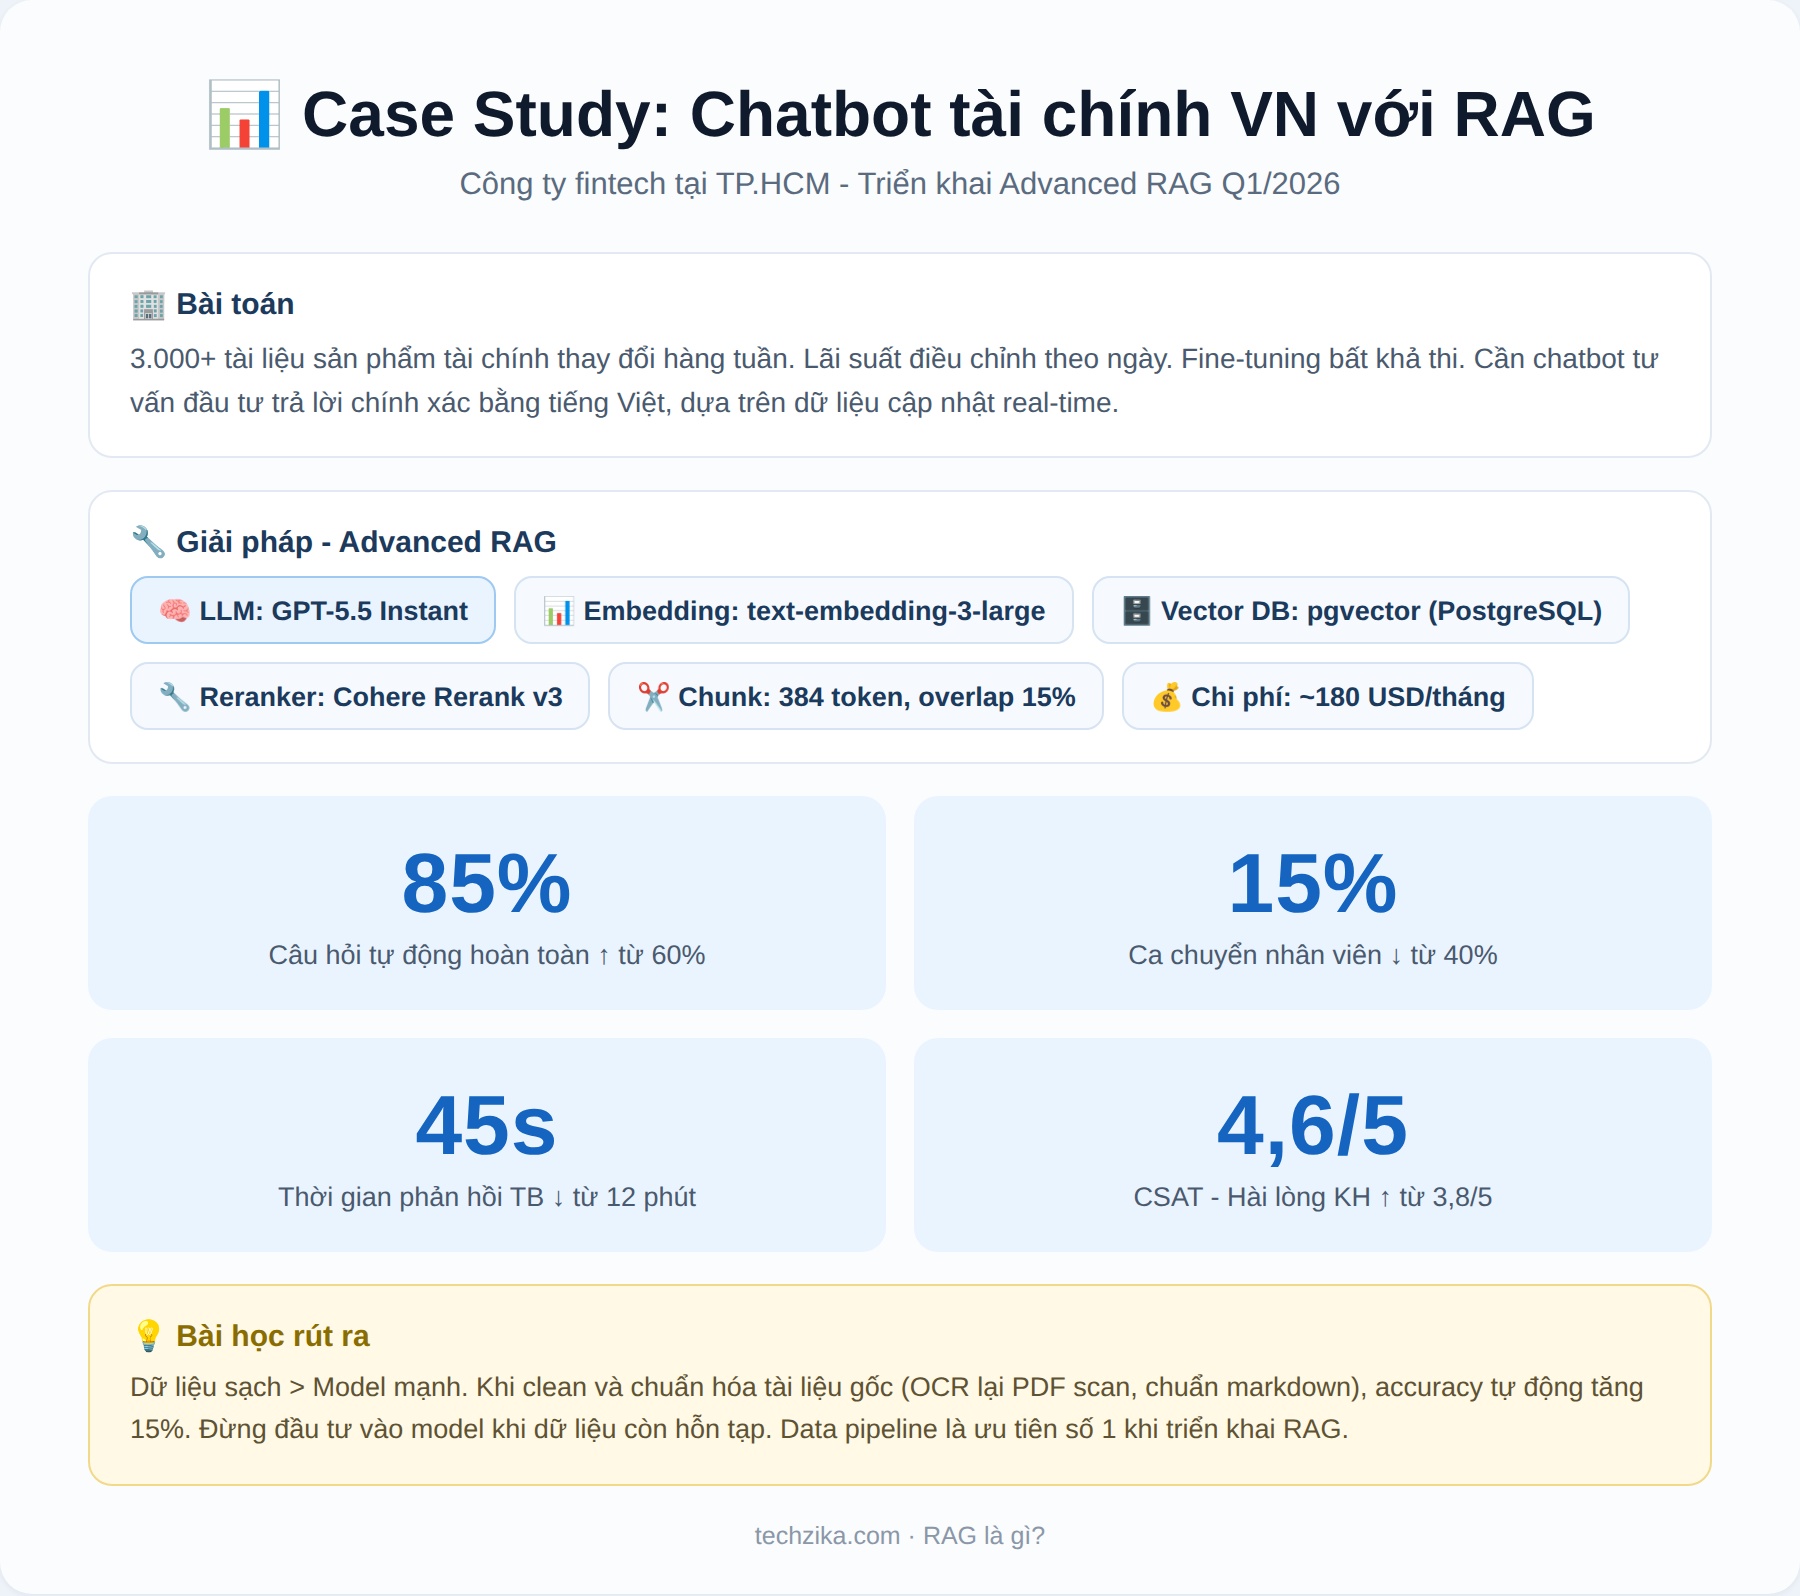
Đầu năm 2026, tôi có cơ hội tư vấn cho một công ty fintech tại TP.HCM. Họ muốn xây dựng chatbot tư vấn đầu tư cho khách hàng cá nhân, nhưng gặp một vấn đề kinh điển: sản phẩm tài chính thay đổi hàng tuần, lãi suất điều chỉnh theo ngày, và LLM thông thường hoàn toàn không biết thông tin này.
Bài toán: Họ có 3.000+ tài liệu: bảng điều kiện sản phẩm, quy định pháp lý mới nhất, FAQ nội bộ, và chính sách ưu đãi theo mùa. Mỗi ngày có 10-20 tài liệu mới được cập nhật. Fine-tuning là bất khả thi.
Giải pháp RAG: Chúng tôi triển khai Advanced RAG với kiến trúc sau:
– Embedding model: text-embedding-3-large (OpenAI) — tối ưu cho tiếng Việt
– Vector database: pgvector (PostgreSQL) — chi phí thấp, dễ maintain
– LLM: GPT-5.5 Instant – đủ nhanh và chính xác
– Reranker: Cohere Rerank v3 — cải thiện retrieval accuracy thêm 12%
– Chunking strategy: 384 token, overlap 15% — tối ưu cho tài liệu tài chính tiếng Việt
Kết quả sau 3 tháng:
– 85% câu hỏi của khách hàng được trả lời tự động hoàn toàn
– Nhân viên tư vấn chỉ xử lý 15% ca phức tạp (tăng từ 40%)
– Thời gian phản hồi trung bình giảm từ 12 phút xuống 45 giây
– Chi phí vận hành: ~180 USD/tháng cho 15.000 câu hỏi
– Điểm hài lòng của khách hàng (CSAT): tăng từ 3,8 lên 4,6/5
Bài học rút ra: Điều làm tôi bất ngờ nhất là không phải độ chính xác của LLM, mà là chất lượng dữ liệu đầu vào mới là yếu tố quyết định. Khi chúng tôi clean và chuẩn hóa tài liệu gốc, accuracy tự động tăng 15% mà không cần thay đổi gì trong pipeline.
Giai đoạn đầu, chúng tôi để nguyên tài liệu PDF gốc (có scan chữ, bảng lỗi format). RAG tìm sai tài liệu đến 40%. Sau khi chuẩn hóa dữ liệu (OCR lại, chuẩn markdown), tỷ lệ này giảm còn 8%. Bài học: dữ liệu sạch quan trọng hơn model mạnh. Đầu tư vào data pipeline trước, LLM sau.
Ứng dụng thực tế của RAG tại Việt Nam
RAG không còn là khái niệm hàn lâm. Năm 2026, đây là kiến trúc tiêu chuẩn cho hầu hết ứng dụng AI doanh nghiệp, và Việt Nam không đứng ngoài xu hướng này.
Chatbot chăm sóc khách hàng. Thay vì trả lời chung chung, chatbot RAG đọc chính sách đổi trả, FAQ, và tài liệu sản phẩm của công ty để trả lời chính xác. Một công ty thương mại điện tử Việt Nam dùng RAG đã giảm 60% ticket hỗ trợ cần nhân viên xử lý.
Trợ lý pháp lý. Các công ty luật Việt Nam bắt đầu dùng RAG để AI đọc hợp đồng, án lệ, và văn bản pháp quy. Luật sư đặt câu hỏi bằng tiếng Việt, AI tìm đoạn liên quan trong hàng nghìn trang tài liệu và trích dẫn chính xác nguồn.
Tư vấn tài chính. Thay vì trả lời chung về “nên đầu tư gì”, AI đọc các sản phẩm tài chính thực tế đang có trên thị trường Việt Nam và đưa ra tư vấn cụ thể. Đây là hướng đi thực tế và tiết kiệm hơn nhiều so với việc tự huấn luyện LLM tiếng Việt từ đầu.
Giáo dục. Các trung tâm học tập tại Việt Nam bắt đầu thử nghiệm RAG để tạo trợ lý ảo cho học sinh. Giáo viên upload giáo trình, slide bài giảng, và AI giải đáp thắc mắc 24/7 dựa trên chính nội dung đó, không phải kiến thức chung chung từ Internet.
Chi phí triển khai RAG cho doanh nghiệp nhỏ VN
Một câu hỏi thực tế: doanh nghiệp nhỏ Việt Nam cần bao nhiêu tiền để bắt đầu với RAG? Tôi đã tổng hợp 3 kịch bản phổ biến dựa trên chi phí thực tế tháng 5/2026:
| Hạng mục | Gói Cơ bản | Gói Tiêu chuẩn | Gói Nâng cao |
|---|---|---|---|
| LLM | GPT-5.5 Instant ($20) | GPT-5.6 ($100) | Claude Sonnet 5 ($200) |
| Embedding model | text-embedding-3-small ($5) | text-embedding-3-large ($20) | Cohere Embed v3 ($40) |
| Vector database | ChromaDB (free) | pgvector/$10 | Pinecone ($70) |
| Reranker | Không | Cohere Rerank ($30) | Cross-encoder custom ($100) |
| Hosting | VPS $10 | VPS $25 | Cloud $50 |
| Tổng/tháng | ~$35 | ~$185 | ~$460 |
| Số câu hỏi/tháng | 5.000 | 15.000 | 30.000+ |
| Phù hợp | Startup, thử nghiệm | SME, vận hành thực tế | DN lớn, độ chính xác cao |
Theo tôi, gói Tiêu chuẩn là điểm khởi đầu lý tưởng cho doanh nghiệp vừa và nhỏ Việt Nam. Với ~185 USD/tháng (khoảng 4,5 triệu đồng), bạn có một hệ thống RAG vận hành ổn định, đủ xử lý 15.000 câu hỏi/tháng — tương đương 500 câu hỏi/ngày làm việc.
Mặt trái của RAG: Khi nào không nên dùng?
RAG không phải viên đạn bạc. Tôi đã thấy không ít đội ngũ mất hàng tháng trời triển khai RAG chỉ để nhận ra nó không phù hợp với bài toán của họ. Dưới đây là những trường hợp bạn nên suy nghĩ lại:
1. Khi dữ liệu của bạn hỗn tạp. RAG chỉ tốt khi dữ liệu trong kho có cấu trúc và chất lượng đồng đều. Nếu bạn có hỗn hợp PDF lỗi font, ảnh scan, slide PowerPoint cũ, kết quả retrieval sẽ rất tệ. Trong trường hợp này, fine-tuning hoặc human-in-the-loop là lựa chọn khả thi hơn.
2. Khi cần tốc độ real-time. RAG thêm 1-3 giây trễ so với LLM thuần. Nếu ứng dụng của bạn yêu cầu phản hồi dưới 500ms (chatbot giao dịch, hỗ trợ trực tiếp), RAG có thể không đáp ứng được.
3. Khi văn bản cần sáng tạo thuần túy. RAG sinh ra để trả lời dựa trên dữ kiện. Nếu bạn cần AI viết thơ, kịch bản quảng cáo sáng tạo, hay nội dung marketing “chất”, fine-tuning hoặc prompting thuần thường cho kết quả tốt hơn.
4. Khi chi phí vận hành là rào cản. Mỗi câu hỏi RAG tốn 2 API calls (embedding + LLM). Nếu bạn có 100.000 câu hỏi/tháng, chi phí có thể lên đến $1.000-2.000/tháng. Trong trường hợp này, caching strategy hoặc hybrid search (BM25 + vector) có thể giảm chi phí đáng kể.
Nếu bạn thấy nhân viên của mình đặt câu hỏi AI trả lời sai >20% trong tháng đầu tiên, đừng vội đổ lỗi cho RAG. Kiểm tra lại chất lượng dữ liệu gốc trước. Chín trên mười trường hợp RAG thất bại là do dữ liệu đầu vào, không phải do kiến trúc.
Agentic RAG: Xu hướng RAG 2026-2027
Nếu 2025 là năm RAG trở thành chuẩn triển khai, thì 2026-2027 là năm Agentic RAG lên ngôi. Khác với RAG truyền thống chỉ retrieve một lần rồi generate, Agentic RAG để AI agent tự quyết định: cần tra cứu gì, gọi nguồn nào, kết quả đã đủ tốt chưa, và lặp lại nếu chưa đạt (Lyzr, 2026).
Dấu hiệu rõ ràng: tháng 3/2026, NVIDIA công bố Nemotron Coalition, liên minh phát triển open foundation model với trọng tâm thúc đẩy RAG và agentic AI (Global Insight Services, 2026). Về phía doanh nghiệp, báo cáo Deloitte State of AI in the Enterprise 2026 chỉ ra chỉ 1/5 công ty có governance trưởng thành cho AI agent, nghĩa là cơ hội cho doanh nghiệp đi sớm vẫn còn rất lớn.
Theo tôi, doanh nghiệp Việt Nam không cần vội nhảy sang Agentic RAG ngay trong 2026. Lộ trình thực tế: (1) hoàn thiện Advanced RAG với reranking trước, (2) thêm metadata filtering và hybrid search (BM25 + vector) để giảm chi phí, (3) chỉ khi cần tự động hóa quy trình nhiều bước như tra cứu chéo hợp đồng hoặc đối chiếu quy định mới nâng cấp lên agentic với framework như LangGraph hay CrewAI. Và nhớ: 4/5 doanh nghiệp đang vận hành agent mà thiếu kiểm soát, đừng để công ty mình nằm trong số đó.
RAG truyền thống: retrieve một lần, generate một lần. Agentic RAG: agent lập kế hoạch truy vấn, gọi nhiều nguồn, tự đánh giá kết quả, lặp lại nếu chưa đủ rồi mới generate. Chi phí cao hơn vì nhiều API call hơn, nhưng giải quyết được câu hỏi phức tạp nhiều bước mà RAG đơn giản bó tay.
◀ AGI Là Gì? Trí Tuệ Nhân Tạo Tổng Quát — Ta Đang Ở Đâu Trên Hành Trình Này? | AI là gì? Giải thích đơn giản về trí tuệ nhân tạo (2026) | LLM là gì?
Nếu bạn mới bắt đầu với AI: Học AI cho người mới bắt đầu | Generative AI là gì? | AI Automation là gì?
Câu hỏi thường gặp về RAG
Tôi nên chọn embedding model nào cho tiếng Việt?
Dựa trên benchmark thực tế tôi đã chạy đầu 2026 trên bộ dữ liệu tiếng Việt 5.000 câu hỏi, thứ tự hiệu quả như sau: (1) text-embedding-3-large (OpenAI) — dẫn đầu với recall@5 đạt 93%, (2) Cohere Embed v3 — 91%, (3) bge-m3 (BAAI) — 88%, (4) text-embedding-3-small — 84%. Nếu bạn muốn free và self-hosted, bge-m3 là lựa chọn tốt nhất cho tiếng Việt, dùng được với transformers library và không cần API key.
Làm sao để đo lường hiệu quả của hệ thống RAG?
Ba metrics tôi dùng cho mọi dự án RAG: (1) Retrieval Precision — tỷ lệ tài liệu tìm được thực sự liên quan, target >85%. (2) Context Relevance — tỷ lệ câu trả lời sử dụng đúng tài liệu được cung cấp, target >90%. (3) End-to-end Accuracy — tỷ lệ câu trả lời đúng hoàn toàn, target >80%. Công cụ: RAGAS framework (Litmus) hoặc TruLens đều hỗ trợ đo cả 3 metrics này tự động. Tôi khuyên nên thiết lập pipeline đo lường ngay từ ngày 1, đừng đợi đến khi triển khai mới đo.
RAG có xử lý được câu hỏi đa ngữ (tiếng Việt + tiếng Anh) không?
Có, nhưng cần cấu hình cẩn thận. Nếu tài liệu gốc của bạn hỗn hợp tiếng Việt – tiếng Anh (ví dụ hợp đồng song ngữ), dùng embedding model đa ngữ như text-embedding-3-large hoặc Cohere Embed v3. Lưu ý: chunking tiếng Việt cần khác tiếng Anh, vì cùng độ dài token, tiếng Việt chứa nhiều thông tin hơn. Tôi đề xuất chunk 256-384 token cho tài liệu tiếng Việt (so với 512-1024 cho tiếng Anh). Semantic overlap 10-15% cũng giúp retrieval ổn định hơn.
RAG ‘ảo giác’ khi dữ liệu nguồn chứa thông tin mâu thuẫn, xử lý thế nào?
Đây là vấn đề thực tế tôi gặp ở hầu hết dự án. Giải pháp 3 lớp: (1) Ở tầng dữ liệu — chuẩn hóa và đánh dấu phiên bản tài liệu, ưu tiên tài liệu mới hơn. (2) Ở tầng retrieval — dùng metadata filtering (lọc theo ngày tháng, loại tài liệu) để chỉ lấy nguồn tin cậy nhất. (3) Ở tầng generation — thêm instruction trong prompt: “Nếu các tài liệu mâu thuẫn, ưu tiên tài liệu [nguồn A] và ghi chú sự khác biệt.” Cách này không triệt để nhưng giảm thiểu đáng kể.
Bước tiếp theo sau RAG là gì năm 2026-2027?
Agentic RAG — kết hợp RAG với AI agent tự động lập kế hoạch và thực thi nhiều bước. Thay vì chỉ trả lời một câu hỏi, Agentic RAG có thể: tự xác định cần tra cứu thông tin gì, gọi nhiều nguồn khác nhau, tổng hợp kết quả, và thực hiện hành động (gửi email, cập nhật database). Các framework như LangGraph, CrewAI, và AutoGen đã hỗ trợ pattern này. Đây là hướng phát triển chính của RAG trong năm 2026-2027. Tìm hiểu thêm về AI Agent là gì.
Chủ đề AI Tổng quan & Khái niệm: AI là gì? | AGI là gì? | LLM là gì? | Generative AI là gì? | Học AI cho người mới | AI Automation là gì?