Có một sự thật ít người nói ra: hầu hết ảnh AI bạn thấy trên mạng đều được tạo bởi người mới dùng lần đầu. Prompt 1 dòng, kết quả chung chung, rồi kết luận “AI chưa đủ tốt”.
Tôi cũng từng nghĩ vậy. Cho đến khi dành 2 tuần test 8 công cụ với cùng 3 prompt chuẩn. Kết quả làm tôi bất ngờ: cùng một prompt, Gemini cho ảnh gần như ảnh chụp thật, Midjourney cho ảnh như tranh gallery, còn Ideogram viết text chính xác từng chữ một tiếng Việt.
Bài này là kết quả của 2 tuần test đó. Bạn sẽ biết chính xác nên dùng công cụ nào cho nhu cầu của mình, cách viết prompt ra ảnh đẹp ngay lần đầu, và những cạm bẫy pháp lý mà 90% người dùng bỏ qua.
Điều quan trọng nhất không phải là công cụ đắt tiền. Tôi thấy rất nhiều người mua Midjourney hay ChatGPT Plus ngay lập tức, trong khi chưa biết viết prompt đúng cách. Kết quả: ảnh ra còn thua Gemini miễn phí. Hãy bắt đầu với công cụ miễn phí, học prompt trước, nâng cấp sau.
Công nghệ đứng sau một bức ảnh AI
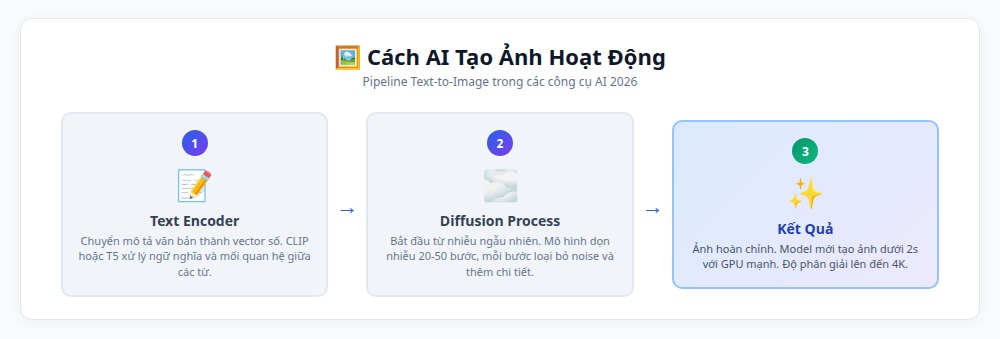
Bạn gõ một câu mô tả, vài giây sau có ngay một bức ảnh. Nghe như ảo thuật, nhưng thực ra nó là kết quả của 3 công nghệ xếp chồng lên nhau.
Thứ nhất: Mô hình khuếch tán (Diffusion Model). Đây là trái tim của hầu hết công cụ tạo ảnh hiện nay. Cách nó hoạt động khá ngược đời: bắt đầu từ một màn nhiễu hoàn toàn ngẫu nhiên, sau đó “dọn nhiễu” từng bước một. Mỗi bước, mô hình đoán xem pixel nào là nhiễu và loại bỏ nó, cho đến khi hình ảnh xuất hiện rõ ràng. Giống như bạn nhìn vào một tấm kính mờ và từ từ lau sạch nó vậy.
Thứ hai: Text Encoder. Đây là cầu nối giữa ngôn ngữ con người và không gian số. Khi bạn viết “một chú mèo cam đeo kính râm ngồi trên ghế bãi biển”, text encoder chuyển câu này thành một vector số mà diffusion model hiểu được. CLIP của OpenAI và T5 của Google là hai text encoder phổ biến nhất. Chất lượng text encoder quyết định trực tiếp độ chính xác của ảnh đầu ra.
Thứ ba: Cơ chế Attention. Đây là thứ giúp model hiểu được mối quan hệ giữa các phần trong prompt. “Mèo cam” phải là màu cam chứ không phải màu đen. “Đeo kính râm” phải ở trên mặt mèo, không phải ở đâu đó trong ảnh. Attention map giúp model tập trung vào đúng vùng khi tạo từng pixel.
Kết hợp cả 3 thứ này, bạn có một pipeline đầy đủ: Text → Vector → Noise → Denoising → Image. Năm 2026, pipeline này đã nhanh hơn rất nhiều. Một số model như Flux có thể tạo ảnh trong dưới 2 giây với GPU mạnh.
8 công cụ tạo ảnh AI tốt nhất 2026: Tôi đã test từng cái
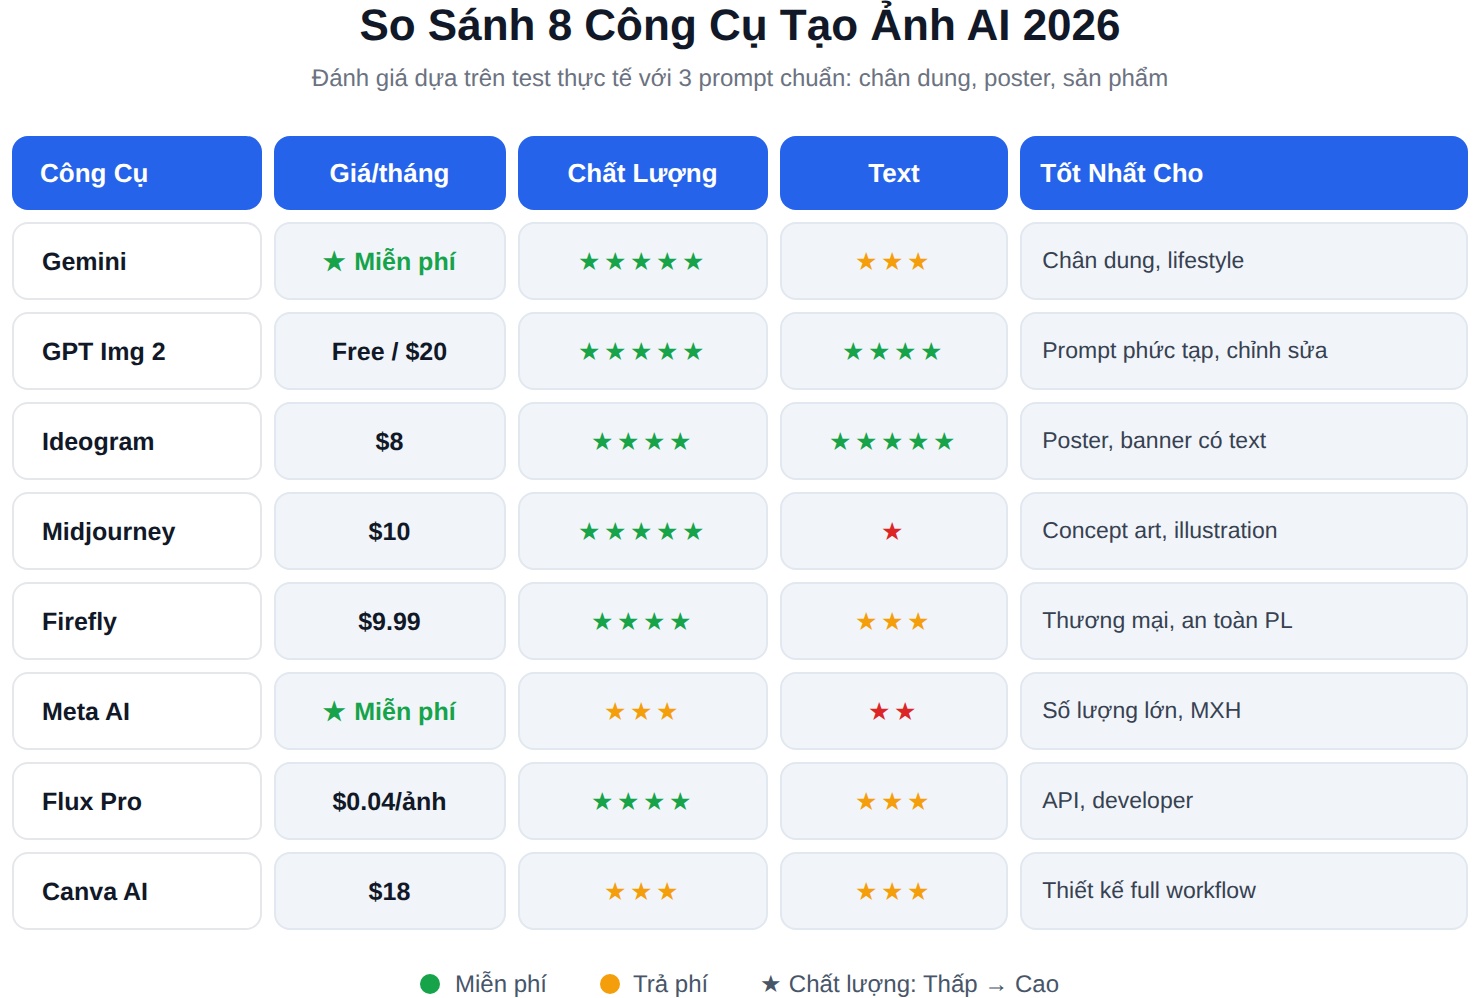
Không phải xếp hạng chủ quan. Tôi đã dành 2 tuần test 8 công cụ với cùng 3 prompt chuẩn: chân dung người Việt, poster sự kiện có text tiếng Việt, và ảnh sản phẩm thương mại. Mỗi công cụ 5 lần chạy, lấy kết quả tốt nhất. Dưới đây là những gì tôi thấy.
1. Google Gemini (Nano Banana 2) – Miễn phí, chất lượng bất ngờ
Gemini đang là công cụ miễn phí tốt nhất thị trường. Không nói quá. Chất lượng ảnh chân dung của Gemini 2 gần như không thể phân biệt với ảnh chụp thật, đặc biệt là cách nó xử lý ánh sáng và texture da.
Điểm mạnh thực sự của Gemini là khả năng “hiểu” thế giới thực. Google đã index hàng tỷ ảnh sản phẩm và lifestyle qua Search và Shopping. Khi bạn mô tả một sản phẩm cụ thể, Gemini biết chính xác nó trông như thế nào thay vì đoán từ dữ liệu training chung chung.
Dòng model Nano Banana của Google đã tạo cú hích lớn: thu hút hơn 10 triệu người dùng mới và xử lý hơn 200 triệu lượt chỉnh sửa ảnh chỉ trong vài tuần đầu ra mắt. Bản mới nhất Nano Banana 2 (Gemini 3.1 Flash Image, ra mắt 26/2/2026) tạo ảnh nhanh hơn, hiểu yêu cầu tốt hơn và render text sắc nét hơn hẳn bản đầu tiên, còn Nano Banana Pro (Gemini 3 Pro Image) mạnh nhất về độ chân thực và hỗ trợ tới 4K (theo Modelize).
Test thực tế của tôi: Prompt “Cô gái Việt Nam mặc áo dài trắng, đứng trước cổng làng cổ, ánh nắng chiều vàng nhạt”. Gemini tạo ra ảnh có chi tiết áo dài chính xác, ánh sáng hoàng hôn tự nhiên, background kiến trúc Việt hợp lý. Không phải kiểu “châu Á chung chung” như nhiều công cụ khác.
| Tiêu chí | Đánh giá |
|---|---|
| Giá | Miễn phí (~20 ảnh/ngày), $19,99/tháng cho Google AI Pro (trước đây là Google One AI Premium) |
| Chất lượng chân dung | 9/10 – Gần như ảnh thật |
| Text trong ảnh | 7/10 – Text ngắn ổn, text dài dễ lỗi chính tả |
| Tốt nhất cho | Ảnh chân dung, lifestyle, sản phẩm thực tế |
2. ChatGPT GPT Image 2 – Vua prompt phức tạp
OpenAI đã thay DALL-E 3 bằng GPT Image 2 từ tháng 4/2026. Đây không đơn thuần là bản nâng cấp, nó là một hệ thống hoàn toàn mới, được tích hợp thẳng vào ChatGPT thay vì là model riêng biệt.
Sức mạnh lớn nhất của GPT Image 2 là prompt adherence – khả năng theo sát yêu cầu. Khi prompt của bạn có 5-7 yêu cầu cụ thể (chủ thể, bối cảnh, ánh sáng, bố cục, phong cách, text), hầu hết công cụ sẽ bỏ qua 2-3 yêu cầu. GPT Image 2 giữ được tất cả.
Tính năng độc đáo: bạn có thể chỉnh sửa ảnh bằng hội thoại. “Chuyển background sang màu xanh”, “Xóa cái cây bên trái”, “Làm sáng hơn một chút” – nó áp dụng từng thay đổi mà không cần tạo lại từ đầu.
Một bước tiến quan trọng hơn: GPT Image 2 (ra mắt 21/4/2026) là model tạo ảnh đầu tiên có bước “suy nghĩ” trước khi vẽ. Nó lên kế hoạch bố cục, có thể tìm kiếm web để tham khảo hình ảnh thực tế, rồi tự kiểm tra lại output trước khi trả kết quả. Chính lớp reasoning này là lý do độ chính xác của nó bỏ xa các model cùng thời (theo Tech Insider).
3. Ideogram 4 – Vô đối về text trong ảnh
Nếu bạn cần tạo poster, banner quảng cáo, hay bất kỳ ảnh nào có chữ bên trong, Ideogram là lựa chọn số một. Không còn nghi ngờ gì nữa.
Đến 2024, text rendering vẫn là điểm yếu chí mạng của mọi công cụ AI tạo ảnh. Chữ bị méo, sai chính tả, ký tự ngẫu nhiên. Ideogram được xây dựng để giải quyết đúng vấn đề này, và đến 2026 họ vẫn dẫn đầu.
Test của tôi: Prompt tạo poster “Hội Thảo Khởi Nghiệp 2026” với text tiếng Việt. Ideogram 4 cho text chính xác 5/5 lần, font chữ rõ ràng, bố cục chuyên nghiệp. Midjourney V8.1: chữ “Khởi Nghiệp” thành “Khỏi Nghiep” hoặc “Khoi Nghiep” 4/5 lần.
Ideogram cũng vừa ra mắt API cho doanh nghiệp, cho phép tích hợp vào workflow tự động. Từ 3/6/2026, Ideogram 4 chính thức ra mắt kèm bản open-weight ngay từ đầu, cho phép doanh nghiệp tự host và kiểm soát hoàn toàn dữ liệu. $8/tháng cho gói cơ bản.
4. Midjourney V8.2 – Đỉnh cao nghệ thuật
Midjourney V8.2 vẫn là vua về chất lượng nghệ thuật. Bản alpha V8 ra mắt 17/3/2026, V8.1 ra mắt 14/4/2026 và trở thành phiên bản mặc định từ 10/6/2026; đến 24/7/2026, Midjourney đã chuyển sang bản mặc định mới V8.2 với tốc độ và chất lượng được cải thiện thêm. Không công cụ nào tạo ra ảnh có “chất” như Midjourney – ánh sáng điện ảnh, composition tinh tế, màu sắc có chiều sâu.
Nhưng có 3 điểm yếu cần biết: (1) Không có bản miễn phí, bắt đầu từ $10/tháng. (2) Đã có giao diện web riêng hoàn chỉnh, không còn phụ thuộc Discord như trước. (3) Text rendering vẫn tệ – không nên dùng cho bất kỳ ảnh nào cần chữ.
Midjourney phù hợp nhất cho: concept art, illustration, ảnh bìa sách, moodboard sáng tạo. Không phù hợp cho: poster sự kiện, banner quảng cáo, ảnh sản phẩm cần text.
5. Adobe Firefly – An toàn pháp lý tuyệt đối
Điểm khác biệt của Firefly không nằm ở chất lượng ảnh (dù nó khá tốt), mà ở tính an toàn pháp lý. Firefly được train HOÀN TOÀN trên Adobe Stock – ảnh đã được cấp phép. Không craw web, không đào ảnh từ mạng xã hội.
Hệ quả: Adobe cung cấp IP indemnification – nếu bạn bị kiện vì bản quyền ảnh tạo bởi Firefly, Adobe sẽ bảo vệ pháp lý cho bạn. Không công cụ nào khác làm điều này.
Dành cho: doanh nghiệp dùng ảnh AI trong quảng cáo trả phí, bao bì sản phẩm, tài liệu thương mại. $9,99/tháng.
6. Meta AI – Miễn phí, không giới hạn
Meta AI là công cụ duy nhất không có giới hạn tạo ảnh hàng ngày. Chất lượng không bằng Gemini hay GPT Image 2, nhưng nó miễn phí và có sẵn trong Messenger, Instagram, WhatsApp.
Phù hợp cho: tạo số lượng lớn, test nhanh concept, nội dung mạng xã hội hàng ngày. Không phù hợp cho ảnh thương mại cao cấp.
7. FLUX.2 – API mạnh cho developer
FLUX.2 (từ Black Forest Labs, đội ngũ cũ của Stability AI) đang là model được ưa chuộng nhất trong cộng đồng developer. Bản klein (ra mắt 15/1/2026) là lựa chọn nhanh và rẻ nhất, bản dev là open-weights để tự host. Tốc độ nhanh (dưới 2 giây/ảnh), chất lượng cao, hỗ trợ API tốt.
Không có giao diện người dùng – bạn cần gọi qua API hoặc dùng qua nền tảng trung gian như Replicate, Together AI. Chi phí khoảng $0,04/ảnh, rẻ nhất trong các model premium.
8. Canva AI – Cho người không chuyên thiết kế
Canva tích hợp AI tạo ảnh trực tiếp vào workflow thiết kế. Bạn không cần rời khỏi Canva để tạo ảnh rồi import vào – mọi thứ trong cùng một màn hình.
Chất lượng ảnh ở mức khá, không bằng các công cụ chuyên biệt. Nhưng lợi thế là hệ sinh thái: template, font, stock photo, brand kit – tất cả có sẵn. $18/tháng cho Canva Pro.
So sánh nhanh: Chọn công cụ nào cho nhu cầu của bạn?
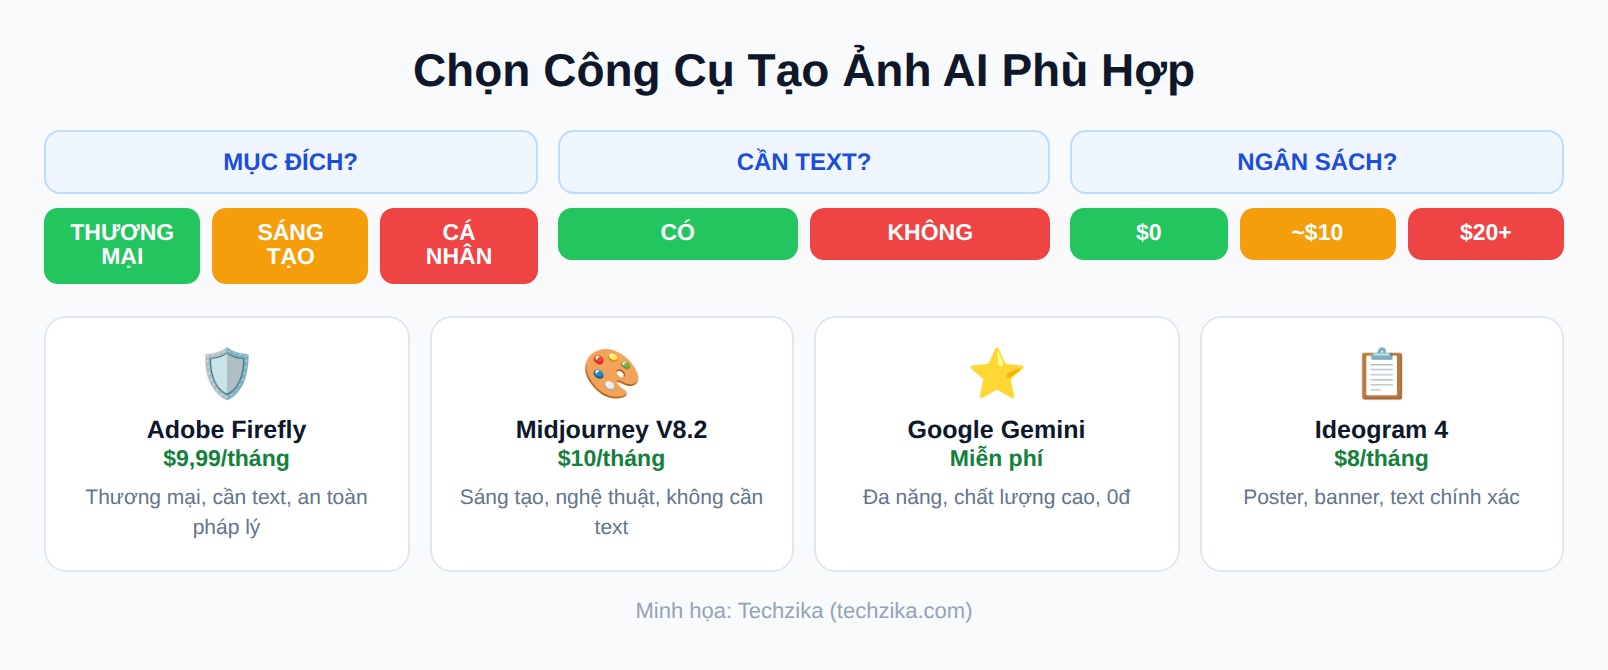
Tôi tổng hợp thành một nguyên tắc đơn giản: đừng chọn công cụ, hãy chọn theo task. Cùng một người, sáng tạo poster thì dùng Ideogram, chiều làm ảnh sản phẩm thì dùng Gemini, tối làm concept art thì dùng Midjourney. Không có one-size-fits-all.
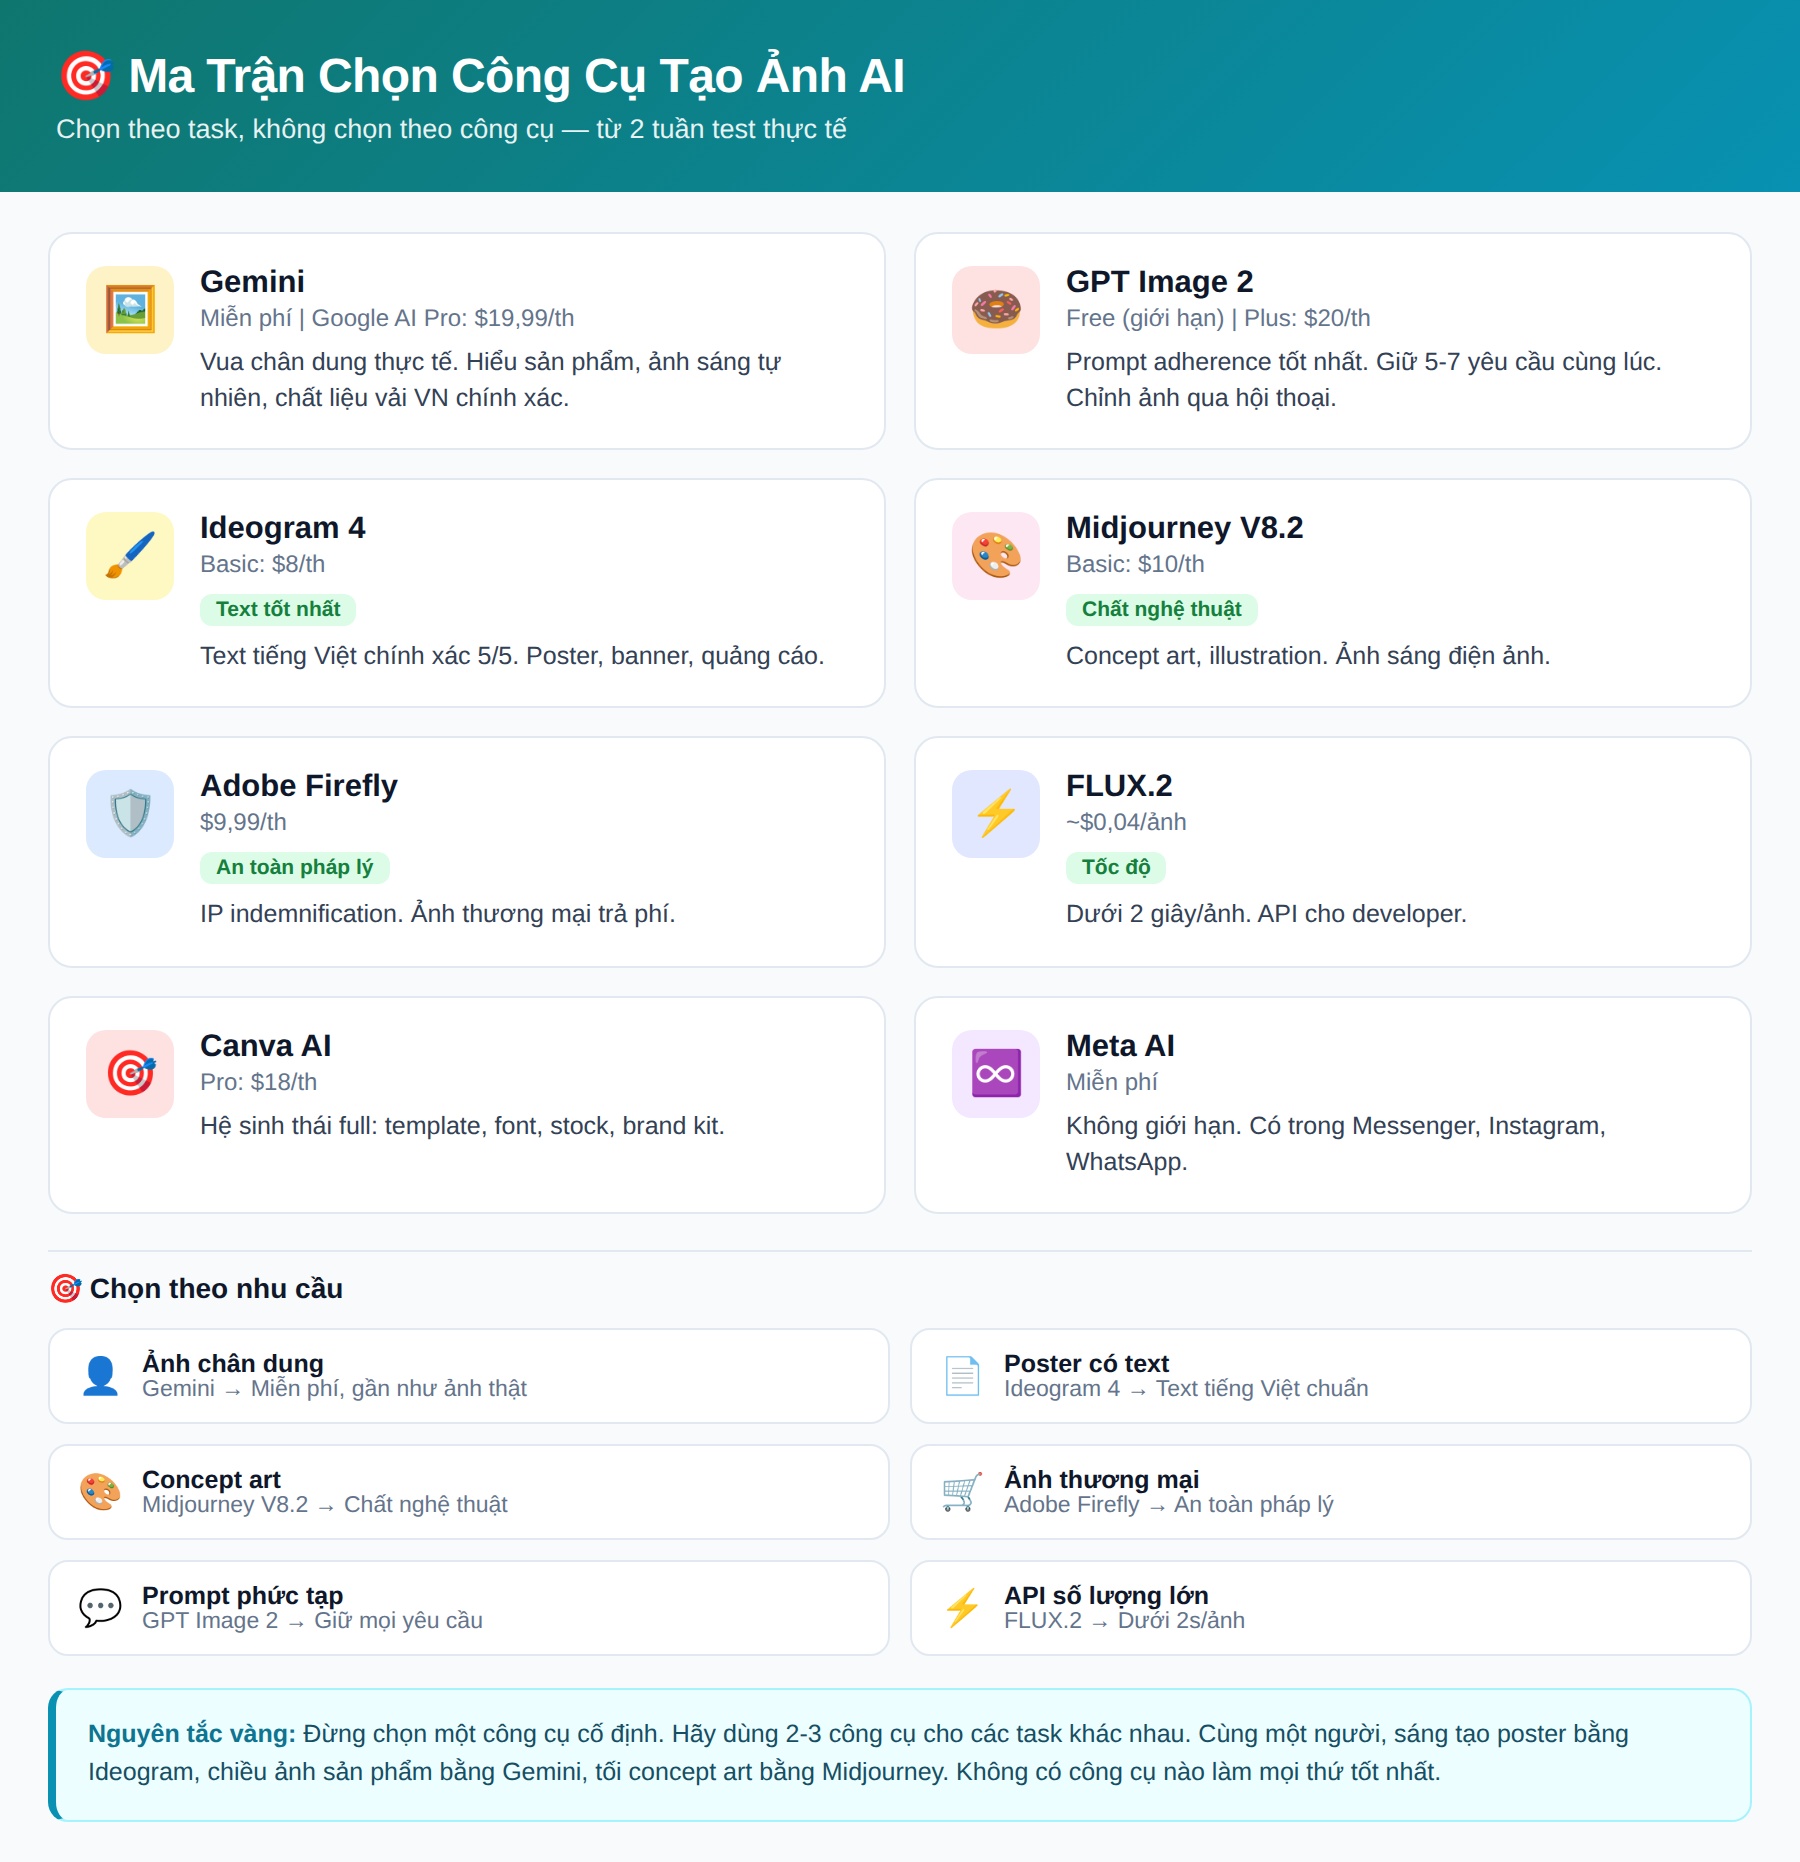
| Nhu cầu | Công cụ tốt nhất | Chi phí/tháng |
|---|---|---|
| Ảnh chân dung / lifestyle | Gemini | Miễn phí |
| Poster / banner có text | Ideogram 4 | $8 |
| Concept art / illustration | Midjourney V8.2 | $10 |
| Ảnh thương mại an toàn | Adobe Firefly | $9,99 |
| Prompt phức tạp, nhiều yêu cầu | GPT Image 2 | Miễn phí (giới hạn) / $20 |
| Số lượng lớn, API | FLUX.2 | ~$0,04/ảnh |
| Thiết kế full workflow | Canva AI | $18 |
| Số lượng không giới hạn | Meta AI | Miễn phí |
Những cái tên mới đáng chú ý giữa 2026
Ngoài 8 công cụ tôi test ở trên, thị trường còn vài cái tên mới đang tăng tốc rất nhanh và đáng để theo dõi:
| Công cụ | Điểm mạnh | Phù hợp cho |
|---|---|---|
| Imagen 4 (Google) | Ảnh sản phẩm chuẩn studio, hỗ trợ background trong suốt | E-commerce, ảnh sản phẩm |
| Recraft V4.1 | Vector, thiết kế đồ họa, brand asset nhất quán | Designer, brand kit |
| Seedream 5 | Open-source, mạnh về chân dung và text tiếng Việt | Người muốn tự host |
| Grok Imagine | Tích hợp sẵn trong X, tạo ảnh không cần rời app | Social content nhanh |
Điểm chung của các model mới là chạy theo hướng “reasoning”: suy nghĩ trước khi vẽ. Nếu đang chọn công cụ mới, hãy ưu tiên model có bước lên kế hoạch bố cục (như GPT Image 2, Nano Banana Pro) thay vì model vẽ thẳng từ prompt.
Nghệ thuật viết prompt: Tại sao cùng công cụ, người ra ảnh đẹp người ra ảnh xấu?
Đây là câu hỏi tôi nhận được nhiều nhất. Sau hàng trăm lần test, tôi rút ra: 80% chất lượng ảnh đến từ prompt, 20% đến từ công cụ. Cùng Gemini, có người ra ảnh như ảnh chụp studio, có người ra ảnh như tranh vẽ lớp 3. Khác biệt nằm ở cách viết prompt.
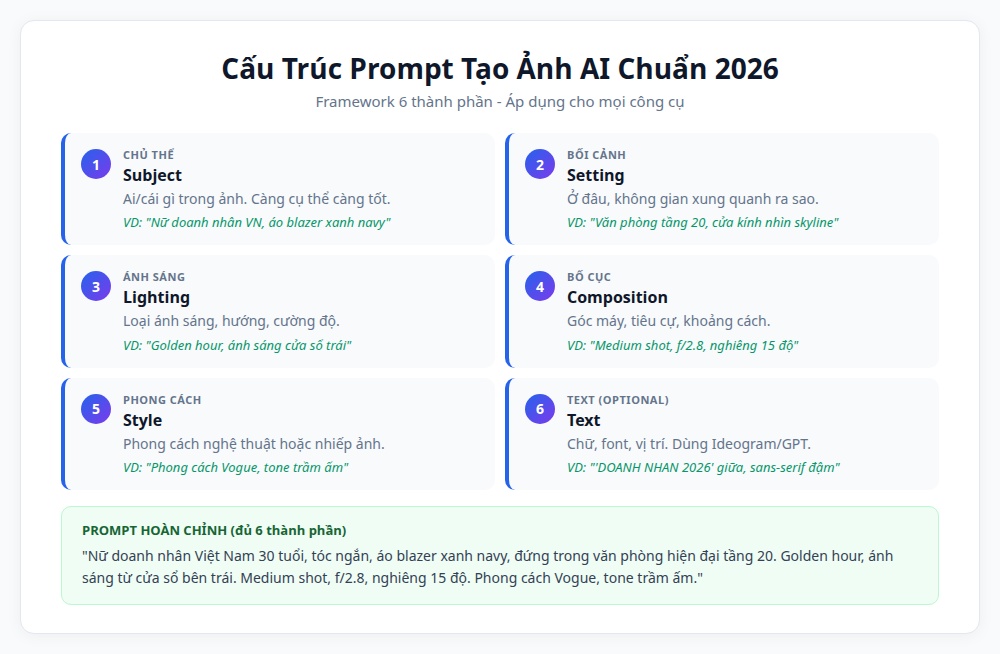
Framework 6 thành phần rất hiệu quả, nhưng không phải lúc nào cũng cần đủ 6. Với ảnh chân dung đơn giản, tôi chỉ dùng 3-4 thành phần (chủ thể + bối cảnh + ánh sáng). Với ảnh quảng cáo phức tạp mới cần đủ 6. Đừng biến việc viết prompt thành một công thức cứng nhắc, hãy linh hoạt theo nhu cầu thực tế.
Cấu trúc prompt 6 thành phần
Tôi dùng framework 6 thành phần cho mọi prompt. Không phải lúc nào cũng cần đủ 6, nhưng càng nhiều càng chính xác:
- Chủ thể (Subject): Ai/cái gì trong ảnh? Càng cụ thể càng tốt. “Một người phụ nữ” thì kém hơn “một phụ nữ Việt Nam 30 tuổi, tóc đen dài, mặc áo sơ mi trắng”.
- Bối cảnh (Setting): Ở đâu? “Trong quán cà phê vintage, ánh sáng ấm, ghế gỗ tối màu”.
- Ánh sáng (Lighting): Loại ánh sáng? Hướng? “Golden hour, ánh sáng từ cửa sổ bên trái, bóng đổ nhẹ”.
- Bố cục (Composition): Góc máy? Tiêu cự? “Medium shot, f/2.8, hơi nghiêng 15 độ”.
- Phong cách (Style): Nhiếp ảnh? Minh họa? 3D render? “Phong cách nhiếp ảnh Fujifilm, tone màu ấm”.
- Text (nếu cần): Chữ gì? Font? Vị trí? “Dòng chữ ‘Summer Sale’ nằm giữa, font sans-serif đậm, màu trắng”.
Ví dụ thực tế: từ prompt yếu đến prompt mạnh
Prompt yếu: “Một bức ảnh đẹp về cà phê”
→ Kết quả: Ảnh cà phê chung chung, không kiểm soát được gì.
Prompt trung bình: “Một tách cà phê trên bàn gỗ”
→ Kết quả: Tốt hơn, nhưng vẫn random về ánh sáng, góc máy, style.
Prompt mạnh: “Cận cảnh tách cà phê espresso trên bàn gỗ rustic, crema dày màu nâu vàng, ánh sáng tự nhiên từ cửa sổ bên phải tạo bóng đổ dài, hơi nước mỏng bay lên, phong cách nhiếp ảnh food magazine, f/1.8 shallow depth of field, tone màu ấm”
→ Kết quả: Ảnh có kiểm soát gần như hoàn toàn.
Khác biệt: prompt mạnh mất thêm 30 giây để viết, nhưng tiết kiệm 5-10 lần re-prompt.
Hạn chế của AI Tạo Ảnh Bạn Cần Biết
Tôi đã dành phần lớn bài viết để nói về mặt mạnh. Nhưng nếu chỉ nói một chiều, bạn sẽ thất vọng khi dùng thực tế. Dưới đây là những hạn chế tôi gặp phải sau 2 tuần test.
1. Chi tiết phức tạp vẫn là điểm yếu. Tay người, mắt, và các chi tiết đối xứng vẫn là tử huyệt của mọi model. Nếu prompt của bạn yêu cầu “người đang cầm ly cà phê bằng tay phải”, 3/5 lần tay sẽ bị méo hoặc thiếu ngón. Giải pháp: dùng inpainting để sửa hoặc chấp nhận chụp nhiều lần.
2. Không nhất quán về style xuyên nhiều ảnh. Nếu bạn cần 10 ảnh cho cùng một chiến dịch với style đồng nhất, AI vẫn thất bại. Mỗi lần generate cho output khác nhau. Không có “brand guideline” cho AI. Giải pháp: dùng seed number nếu công cụ hỗ trợ, hoặc tạo một ảnh gốc và dùng image-to-image để giữ style.
3. Chi phí ẩn khi dùng ở quy mô lớn. Gemini miễn phí 20 ảnh/ngày nghe có vẻ nhiều. Nhưng thực tế, để có 1 ảnh đẹp, bạn phải tạo 5-10 ảnh rồi chọn lọc. 20 ảnh/ngày thực chất chỉ cho bạn 2-4 ảnh dùng được. Nếu cần nhiều, bạn phải nâng cấp hoặc chuyển công cụ.
4. Phụ thuộc hoàn toàn vào internet + GPU cloud. Không có mạng, không tạo được ảnh. Không có GPU cloud mạnh, thời gian tạo ảnh tăng gấp 3-4 lần. Đây là ràng buộc hạ tầng mà ít người nói đến.
Bản quyền ảnh AI: Điều bạn phải biết trước khi dùng
Đây là phần quan trọng nhất mà 90% bài viết tiếng Việt về chủ đề này bỏ qua. Dùng ảnh AI cho mục đích thương mại mà không hiểu luật bản quyền là đang chơi dao.
3 vấn đề pháp lý chính:
1. Bạn có sở hữu ảnh do AI tạo ra không? Câu trả lời phụ thuộc vào điều khoản từng công cụ. Google Gemini và Meta AI cho phép sử dụng thương mại trên bản miễn phí. Midjourney: bạn sở hữu ảnh nếu dùng gói trả phí, nhưng Midjourney giữ quyền dùng ảnh của bạn để train model (trừ gói Pro). Adobe Firefly: bạn sở hữu hoàn toàn + được bảo vệ pháp lý.
2. AI có đang sao chép ảnh có bản quyền không? Về mặt kỹ thuật, diffusion model không lưu trữ ảnh gốc – nó học pattern, style, và concept. Nhưng trong thực tế, một số model có thể tạo ra ảnh gần giống với ảnh trong training data nếu prompt quá cụ thể. Đây là vùng xám pháp lý chưa có án lệ rõ ràng.
3. Luật Việt Nam nói gì? Tính đến 2026, Việt Nam chưa có luật cụ thể về bản quyền AI-generated content. Luật Sở hữu trí tuệ hiện hành bảo vệ “tác phẩm do con người sáng tạo”. Ảnh AI rơi vào vùng không được bảo vệ rõ ràng. Nếu bạn định dùng ảnh AI cho mục đích thương mại tại Việt Nam, nên có người chỉnh sửa đáng kể (human authorship).
Case study: Tôi đã dùng AI tạo ảnh cho dự án thực tế như thế nào
Thay vì nói lý thuyết, tôi chia sẻ một case study thực tế. Dự án: tạo bộ ảnh sản phẩm cho một thương hiệu mỹ phẩm Việt Nam mới ra mắt, với ngân sách ảnh cực thấp.
Bài toán: Cần 20 ảnh sản phẩm + lifestyle cho website và social media. Thuê photographer: 15-20 triệu. Budget hiện tại: 2 triệu.
Giải pháp: Kết hợp AI + chỉnh sửa hậu kỳ. Workflow:
- Chụp 3 ảnh sản phẩm thật bằng điện thoại (background trắng, ánh sáng cơ bản).
- Dùng Adobe Firefly Generative Fill để đặt sản phẩm vào background khác nhau (bàn trang điểm, phòng tắm, spa).
- Dùng Gemini tạo ảnh lifestyle (người mẫu sử dụng sản phẩm) với prompt mô tả chính xác bao bì sản phẩm.
- Designer chỉnh sửa final touch trên Canva (thêm text, logo, color grading).
Kết quả: 20 ảnh trong 3 ngày, tổng chi phí 1,2 triệu (bao gồm 1 tháng Adobe Firefly + Canva Pro). Chất lượng đủ dùng cho website và social, không thua kém ảnh chụp studio tầm trung.
Bài học: AI không thay thế hoàn toàn photographer hay designer. Nó thay thế những shot đơn giản, lặp lại, để team sáng tạo tập trung vào những thứ đòi hỏi tư duy cao hơn.
AI tạo ảnh đang ở giai đoạn ‘đủ tốt’ cho 80% nhu cầu. 20% còn lại (ảnh thương mại cao cấp, concept art đột phá, chiến dịch brand lớn) vẫn cần con người. Nhưng nếu bạn là chủ shop online, content creator, hay marketer, AI đã đủ để thay đổi cách bạn làm việc. Đừng chờ AI hoàn hảo, hãy bắt đầu từ hôm nay.
Xu hướng tạo ảnh AI cuối 2026: Điều gì đang đến?
Nếu bạn nghĩ AI tạo ảnh hiện tại đã ấn tượng, hãy chờ xem 6 tháng tới. 3 xu hướng đang định hình lại ngành:
1. Real-time generation. Flux và SD3,5 đã có thể tạo ảnh dưới 1 giây trên GPU consumer. Điều này mở ra khả năng: chỉnh ảnh real-time khi kéo slider, preview concept trong lúc họp, generative fill ngay trong viewfinder camera.
2. Video generation tích hợp. Các công cụ tạo ảnh đang tích hợp video. Gemini đã có video generation từ text prompt. Midjourney đang test video từ ảnh tĩnh. Xu hướng rõ ràng: ranh giới giữa image và video generator sẽ biến mất trong 12 tháng tới.
3. AI-native editing. Thay vì tạo ảnh mới từ đầu, xu hướng là chỉnh sửa ảnh có sẵn bằng ngôn ngữ tự nhiên. “Đổi background sang bãi biển”, “Thêm một con chó bên trái”, “Làm tối hơn 20%”. GPT Image 2 và Firefly đã làm được, và các công cụ khác đang theo sau.
4. Reasoning image models. Xu hướng lớn nhất nửa cuối 2026: model tạo ảnh bắt đầu “suy nghĩ” trước khi vẽ. GPT Image 2 đi tiên phong với bước lên kế hoạch bố cục và tự kiểm tra output, Nano Banana Pro theo sau với khả năng grounding từ dữ liệu thực tế của Google. Khoảng cách giữa “gõ prompt và cầu may” với “mô tả kết quả là nhận đúng kết quả” đang thu hẹp rất nhanh (theo Tech Insider).
Câu hỏi thường gặp
Công cụ tạo ảnh AI nào miễn phí tốt nhất 2026?
Google Gemini là lựa chọn miễn phí tốt nhất hiện nay, cho phép tạo khoảng 20 ảnh/ngày với chất lượng gần như ảnh thật. Meta AI đứng thứ hai với ưu điểm không giới hạn số lượng, nhưng chất lượng thấp hơn. Cả hai đều cho phép sử dụng thương mại trên bản miễn phí.
Tạo ảnh bằng AI có vi phạm bản quyền không?
Phụ thuộc vào công cụ và mục đích sử dụng. Adobe Firefly train trên ảnh có bản quyền và cung cấp bảo vệ pháp lý. Các công cụ khác train trên dữ liệu public web, đang trong vùng xám pháp lý. Để an toàn, nên chọn Firefly cho mục đích thương mại, hoặc có người chỉnh sửa đáng kể ảnh AI trước khi dùng.
Làm sao để viết prompt tạo ảnh AI đẹp?
Cấu trúc 6 thành phần: Chủ thể + Bối cảnh + Ánh sáng + Bố cục + Phong cách + Text (nếu cần). Dùng reference cụ thể thay vì tính từ trừu tượng. Prompt càng chi tiết, kết quả càng kiểm soát được. Prompt yếu tốn thời gian re-prompt, prompt mạnh mất thêm 30 giây để viết nhưng tiết kiệm hàng chục phút.
Midjourney hay Gemini tốt hơn?
Tùy mục đích. Midjourney vượt trội về chất lượng nghệ thuật, concept art, và ảnh sáng tạo. Gemini vượt trội về ảnh chân dung thực tế, sản phẩm, và đặc biệt là miễn phí. Midjourney có text rendering kém, Gemini làm tốt hơn về text nhưng vẫn thua Ideogram. Nên dùng cả hai cho các mục đích khác nhau thay vì chọn một.
Có cần card đồ họa mạnh để tạo ảnh AI không?
Không, nếu bạn dùng công cụ online (Gemini, ChatGPT, Midjourney). Các công cụ này chạy trên cloud, bạn chỉ cần trình duyệt và internet. Nếu muốn chạy local (Stable Diffusion, Flux), bạn cần GPU tối thiểu 8GB VRAM. Với người dùng phổ thông, cloud-based là đủ và tiện hơn.